WRITING
第四章 调度子系统
第四章 调度子系统
4.1 操作系统原理:CPU 调度的本质
4.1.1 为什么需要调度
在单 CPU 系统中,同一时刻只能有一个进程在运行。但系统中通常有多个进程同时存在(有的在计算,有的在等待 IO,有的在睡眠)。CPU 调度(CPU Scheduling)决定在任意时刻哪个进程占用 CPU,是操作系统实现多任务的核心机制。
调度的目标是在多个相互竞争的进程之间公平分配 CPU 时间,同时兼顾以下指标:
CPU 利用率:CPU 尽可能保持忙碌,不空闲。
吞吐量:单位时间内完成的进程数。
周转时间:从进程提交到完成的总时间。
等待时间:进程在就绪队列中等待的时间。
响应时间:从提交请求到产生第一个响应的时间(对交互系统尤为重要)。
公平性:每个进程获得合理的 CPU 份额,不饿死。
这些目标往往相互冲突(如高响应时间要求频繁切换,而高吞吐量要求减少切换),调度器需要在它们之间权衡。
4.1.2 调度算法的演进
操作系统调度算法经历了长期演进:
先来先服务(FCFS):按到达顺序调度,简单但平均等待时间长,护航效应(短作业被长作业阻塞)。
短作业优先(SJF):优先调度预计运行时间最短的作业,平均等待时间最优,但需要预知运行时间,长作业可能饿死。
时间片轮转(RR):每个进程分配固定时间片,用完则排队到队尾,公平但上下文切换开销大,时间片大小难以选择。
优先级调度:每个进程有优先级,高优先级优先调度,可能导致低优先级饿死(需要老化机制)。
多级反馈队列(MLFQ):多个队列,不同优先级和时间片,进程根据行为动态调整队列,兼顾响应性和吞吐量。
Linux 的 CFS(完全公平调度器)是一种创新的调度算法,不使用传统的时间片,而是通过虚拟运行时间实现公平性。
4.1.3 抢占式调度与非抢占式调度
非抢占式(Non-preemptive):进程一旦获得 CPU,就一直运行直到完成或主动放弃(睡眠/等待 IO)。实现简单但响应性差,不适合交互系统。
抢占式(Preemptive):调度器可以在进程运行中途强制切换 CPU 给更高优先级的进程。响应性好但需要处理同步问题(临界区保护)。
Linux 是抢占式内核(CONFIG_PREEMPT),即使在内核态运行(除了持有自旋锁的临界区)也可以被抢占。
4.2 Linux 调度器架构:调度类
4.2.1 模块化调度类设计
Linux 调度器采用模块化设计,通过调度类(sched_class)实现调度策略的可插拔。每个调度类实现一组操作函数,不同类型的进程使用不同的调度类。
源码位置:include/linux/sched.h
struct sched_class {
    const struct sched_class *next;  /* 指向下一个调度类(按优先级从高到低链接) */

    /* 将任务加入运行队列 */
    void (*enqueue_task)(struct rq *rq, struct task_struct *p, int flags);
    /* 从运行队列移除任务 */
    void (*dequeue_task)(struct rq *rq, struct task_struct *p, int flags);
    /* 任务主动让出 CPU */
    void (*yield_task)(struct rq *rq);
    /* 检查是否需要抢占当前进程 */
    void (*check_preempt_curr)(struct rq *rq, struct task_struct *p, int flags);
    /* 选择下一个要运行的任务 */
    struct task_struct *(*pick_next_task)(struct rq *rq);
    /* 将当前任务放回队列 */
    void (*put_prev_task)(struct rq *rq, struct task_struct *p);
    /* 设置当前任务 */
    void (*set_curr_task)(struct rq *rq);
    /* 时钟中断中调用,更新任务时间统计,检查是否需要抢占 */
    void (*task_tick)(struct rq *rq, struct task_struct *p, int queued);
    /* 新进程创建时的初始化 */
    void (*task_fork)(struct task_struct *p);
    /* 任务从一个 CPU 迁移到另一个 CPU */
    void (*task_migrated)(struct task_struct *p, int new_cpu);
    /* ... */
};
4.2.2 五种调度类
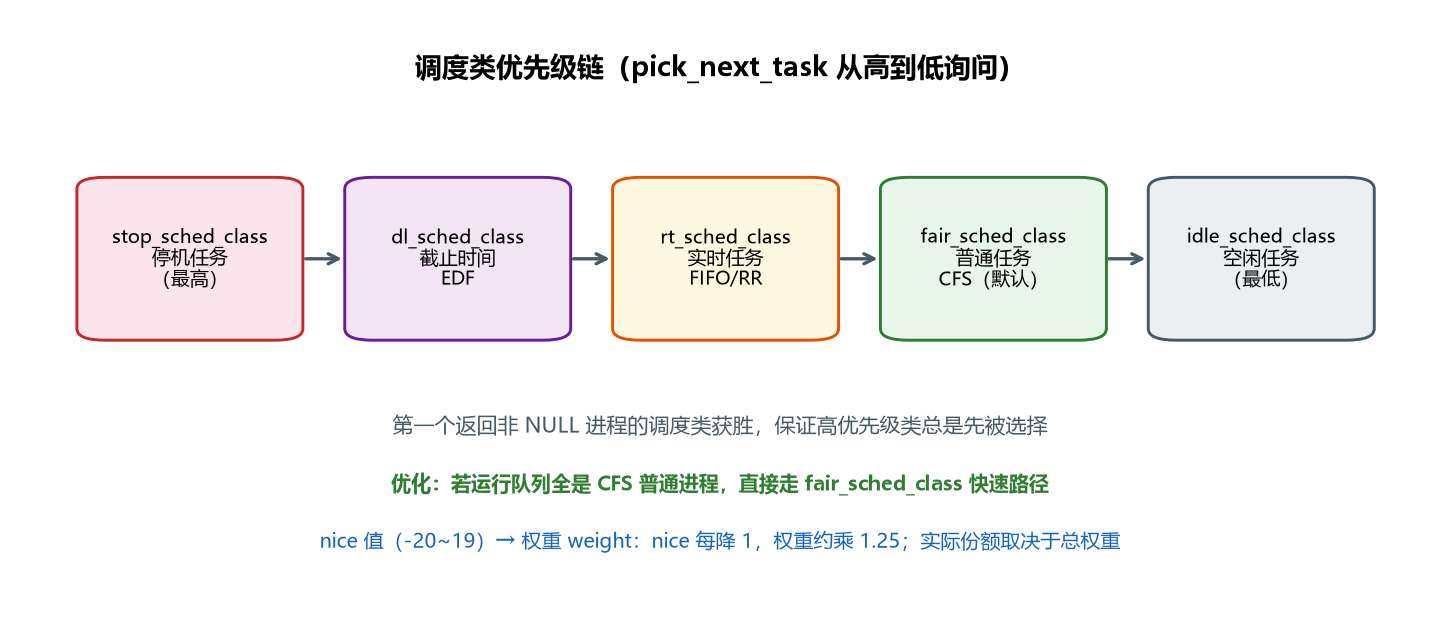
Linux 内核定义了五种调度类,按优先级从高到低排列:
调度类 | 优先级 | 适用进程 | 调度策略 | 源码文件 |
|---|---|---|---|---|
| 最高 | 停机任务(migration/stop) | 强制抢占,运行时其他任务无法运行 |
|
| 高 | 截止时间任务 | Earliest Deadline First(最早截止时间优先) |
|
| 中高 | 实时任务 | SCHED_FIFO(先进先出)/ SCHED_RR(时间片轮转) |
|
| 中(默认) | 普通任务 | CFS 完全公平调度 |
|
| 最低 | 空闲任务(swapper) | 仅在无其他任务时运行 |
|
调度类的链接顺序:所有调度类通过 next 指针链接成一个链表,从高优先级到低优先级:
stop_sched_class → dl_sched_class → rt_sched_class → fair_sched_class → idle_sched_class → NULL
4.2.3 调度策略与 nice 值
用户态可以通过 sched_setscheduler() 设置进程的调度策略:
策略 | 调度类 | 说明 |
|---|---|---|
| fair | 普通进程,CFS 调度,默认策略 |
| fair | 批处理进程,CFS 调度,降低抢占频率,适合 CPU 密集型后台任务 |
| fair | 极低权重的 CFS 策略;普通 fair 任务存在时通常很难获得 CPU,但并非只有系统完全空闲才允许运行 |
| rt | 实时先进先出,无时间片,高优先级可抢占,同优先级按 FIFO |
| rt | 实时时间片轮转,有时间片,用完后排队到同优先级队尾 |
| dl | 截止时间调度,基于 EDF 算法 |
nice 值:对于普通进程(SCHED_NORMAL),通过 nice()/setpriority() 设置 nice 值,范围 -20(最高优先级)到 19(最低优先级),默认 0。nice 值决定进程的权重(weight),权重影响 CFS 中虚拟运行时间的增长速度。
权重与 nice 值的对应关系(kernel/sched/core.c 中的 sched_prio_to_weight 数组):
nice | 权重 weight | 相对 nice=0 的倍数 |
|---|---|---|
-20 | 88761 | 约 86.7 |
-10 | 9548 | 约 9.3 |
0 | 1024 | 1(基准) |
10 | 110 | 约 0.11 |
19 | 15 | 约 0.015 |
nice 每降低 1,权重大约乘以 1.25。某个实体的实际 CPU 份额等于其权重在全部可运行实体总权重中的占比,因此不能把权重倍率直接理解成固定增加 25 个百分点。
这个等比关系是刻意设计的(见 Documentation/scheduler/sched-nice-design.rst),目的是让 nice 成为一个"相对"量:两个进程无论绝对 nice 处在哪个档位,只要相差 1,它们之间的 CPU 分配比例就固定约为 55%∶45%(1.25∶1)。于是 nice +10 对 +11、和 nice -5 对 -4 的分配结果完全相同,用 nice(+1) 调整的效果与当前所处档位无关。也正因为是等比(指数)关系,最末端 nice +19 的权重只有 15,与 nice 0 竞争时大约只能拿到 1.5% 的 CPU;而 SCHED_IDLE 比 nice +19 还弱,但它仍属于 fair 调度类;内核让它保留极小权重,而不是等到系统绝对空闲才允许运行,这也避免了持锁任务因完全得不到 CPU 而放大优先级反转。
4.3 运行队列:struct rq
4.3.1 每 CPU 运行队列
源码位置:kernel/sched/sched.h
每个 CPU 维护一个运行队列 rq,是该 CPU 上所有可运行进程的容器。使用每 CPU 队列避免了全局锁竞争。
struct rq {
    raw_spinlock_t __lock;          /* 运行队列锁 */
    unsigned int nr_running;        /* 可运行进程总数 */
    u64 nr_switches;                /* 上下文切换次数 */
    struct task_struct *curr;        /* 当前运行的进程 */
    struct task_struct *idle;        /* 该 CPU 的 idle 进程(swapper) */
    struct task_struct *stop;        /* 该 CPU 的 stop 进程 */

    u64 clock;                       /* 运行队列时钟(单调递增) */
    u64 clock_task;                  /* 任务时钟(扣除了 irq 时间) */

    /* 各调度类的运行队列 */
    struct cfs_rq cfs;               /* CFS 运行队列 */
    struct rt_rq rt;                  /* 实时运行队列 */
    struct dl_rq dl;                  /* 截止时间运行队列 */

    /* 负载均衡相关(SMP) */
    struct sched_domain __rcu *sd;    /* 当前 CPU 所属调度域 */
    unsigned long cpu_capacity;      /* CPU 计算容量(考虑频率/大小核) */
    struct sched_avg avg_rt, avg_dl; /* RT、DL 类的 PELT 平均负载 */
    int cpu;                         /* 该运行队列所属 CPU 编号 */

    /* 统计信息 */
    atomic_t nr_iowait;               /* 等待 IO 的进程数 */
    unsigned long nr_uninterruptible;  /* 不可中断睡眠的进程数 */
    /* ... */
};
4.3.2 CFS 运行队列:struct cfs_rq
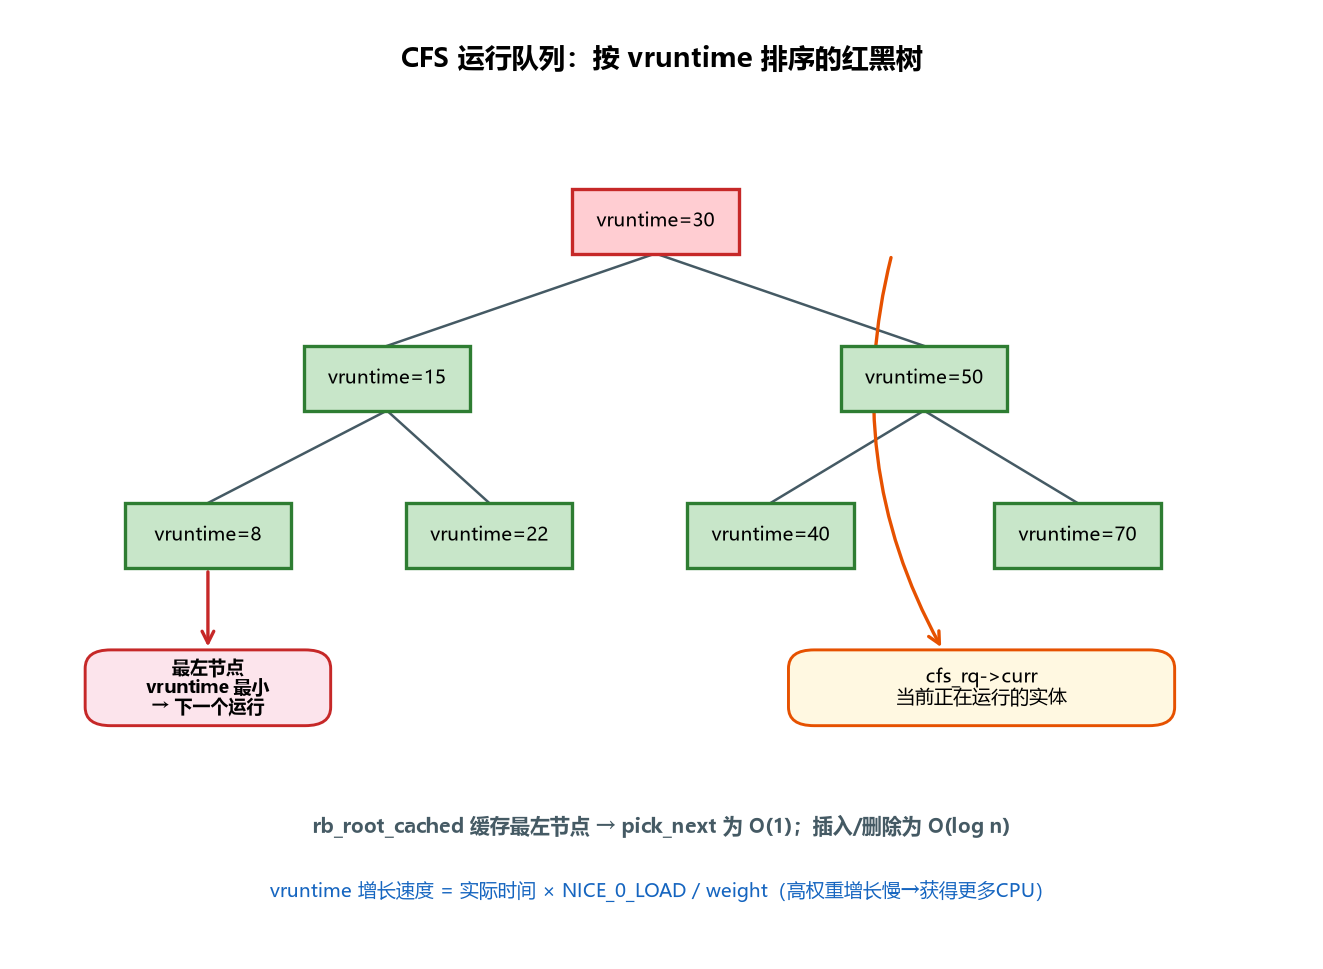
struct cfs_rq {
    struct load_weight load;        /* 队列中所有实体的总权重 */
    unsigned int nr_running;         /* 可运行实体数量 */
    unsigned int h_nr_running;       /* 层次化的可运行数量(含组调度) */

    u64 exec_clock;                  /* 队列执行时钟 */
    u64 min_vruntime;                 /* 队列中最小的 vruntime(用于新进程初始化) */

    struct rb_root_cached tasks_timeline;  /* 红黑树(按 vruntime 排序,缓存最左节点) */
    struct sched_entity *curr;        /* 当前运行的实体 */
    struct sched_entity *next;        /* 唤醒优化:优先挑选的 buddy 实体 */
    struct sched_entity *last;        /* 刚被换下、短期内避免重选的 buddy 实体 */
    struct sched_entity *skip;        /* 显式跳过的实体(如 sched_yield) */

    struct sched_avg avg;             /* PELT 负载跟踪(runnable/util 平均) */
    /* ... 组调度、带宽控制、统计信息 */
};
rb_root_cached 的设计:普通红黑树 rb_root 的最小值查找需要 O(log n)。CFS 频繁需要查找最小 vruntime 的实体,因此使用 rb_root_cached,额外缓存了最左节点(最小值),使得最小值查找变为 O(1)。这是一个重要的性能优化。
4.4 CFS 完全公平调度器
4.4.1 CFS 的核心思想
CFS(Completely Fair Scheduler)从 2.6.23 版本开始引入,取代了之前的 O(1) 调度器。它的基本思路是:
让每个进程获得公平的 CPU 时间份额。
传统调度器常为进程分配离散的固定时间片。CFS 不采用“每个优先级绑定一个固定时间片”的模型,而是用虚拟运行时间(virtual runtime, vruntime)排序,并根据目标调度周期和权重动态算出本轮理想运行时长:
每个可运行的进程维护一个
vruntime,记录它已经"公平地"运行了多久。进程实际运行时,
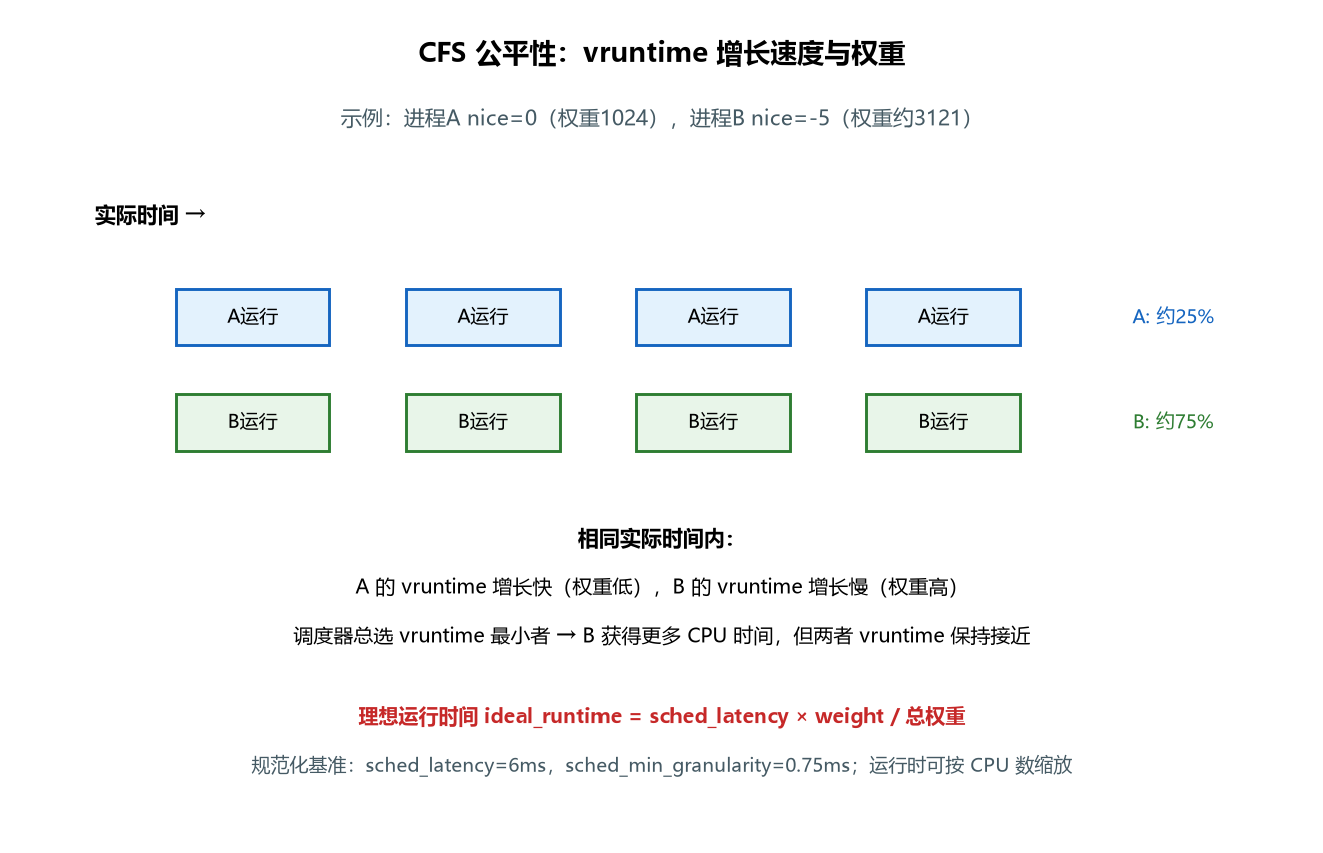
vruntime随实际运行时间增加,但增加的速度与进程的权重(weight)成反比:高权重(高优先级,nice 值低)进程:vruntime 增长慢 → 获得更多 CPU 时间。
低权重进程:vruntime 增长快 → 获得更少 CPU 时间。
CFS 以 vruntime 最小的实体为主要候选;实际选择还会受 buddy 提示、调度粒度和层次化组调度等逻辑影响。
公式:
vruntime += delta_exec * NICE_0_LOAD / weight
其中 delta_exec 是实际运行时间,NICE_0_LOAD 是 nice=0 进程的权重(1024)。
公平性的直观理解: 假设两个 nice=0 的进程(权重相同),它们的 vruntime 增长速度相同。在负载稳定且没有其他约束时,CFS 会围绕较小 vruntime 的实体调度,因此两个进程长期各获得约 50% 的 CPU 时间。这里的公平是按权重统计意义上的近似公平,不表示每个瞬间都严格交替。
如果一个进程 nice=-5(权重 3121,约为 nice=0 的 3.05 倍),它的 vruntime 增长速度约为另一个的 1/3。为了让两者 vruntime 保持接近,高权重进程需要运行约 3 倍的时间——它获得约 75% 的 CPU 时间,另一个获得约 25%。这就是按权重分配 CPU 时间的含义。
4.4.2 调度实体:struct sched_entity
源码位置:include/linux/sched.h
CFS 不直接操作 task_struct,而是通过调度实体(sched_entity)。这是为了支持组调度(Group Scheduling):不仅单个进程可以是调度实体,一个进程组(cgroup)也可以是调度实体,组内的进程再在组内竞争。
struct sched_entity {
    struct load_weight load;       /* 权重(由 nice 值决定) */
    struct rb_node run_node;        /* 在红黑树中的节点 */
    struct list_head group_node;    /* 组调度链表节点 */
    unsigned int on_rq;             /* 是否在运行队列上 */

    u64 exec_start;                 /* 本次运行开始时间(实际时间) */
    u64 sum_exec_runtime;           /* 累计实际运行时间 */
    u64 vruntime;                   /* 虚拟运行时间(CFS 核心) */
    u64 prev_sum_exec_runtime;      /* 上一次切换时的累计运行时间 */

    u64 nr_migrations;              /* CPU 迁移次数 */
    struct sched_statistics statistics;  /* 统计信息(等待时间、运行时间等) */

    /* 组调度相关 */
    struct sched_entity *parent;    /* 父调度实体 */
    struct cfs_rq *cfs_rq;          /* 所属的 CFS 运行队列 */
    struct cfs_rq *my_q;            /* 如果是组实体,指向组内的 CFS 队列 */
};
task_struct 中嵌入了 struct sched_entity se,CFS 通过 se 调度,通过 container_of(se, struct task_struct, se) 可以从 se 找到所属的 task_struct。
4.4.3 更新当前进程的 vruntime:update_curr()
源码位置:kernel/sched/fair.c
update_curr() 是 CFS 中最核心的函数之一,在进程运行过程中被频繁调用(时钟中断、调度、入队出队时),更新当前进程的实际运行时间和虚拟运行时间。
static void update_curr(struct cfs_rq *cfs_rq)
{
    struct sched_entity *curr = cfs_rq->curr;
    u64 now = rq_clock_task(rq_of(cfs_rq));  /* 当前时间(队列时钟) */
    u64 delta_exec;

    if (unlikely(!curr))
        return;

    /* 1. 计算本次运行的实际时间增量 */
    delta_exec = now - curr->exec_start;
    if (unlikely((s64)delta_exec <= 0))
        return;

    /* 2. 更新运行开始时间 */
    curr->exec_start = now;

    /* 3. 累计实际运行时间 */
    curr->sum_exec_runtime += delta_exec;

    /* 4. 核心:更新虚拟运行时间
          vruntime += delta_exec * NICE_0_LOAD / weight */
    curr->vruntime += calc_delta_fair(delta_exec, curr);

    /* 5. 更新队列的 min_vruntime */
    update_min_vruntime(cfs_rq);

    /* 6. 统计信息更新(schedstat、cgroup 计费等) */
    if (entity_is_task(curr)) {
        struct task_struct *curtask = task_of(curr);
        trace_sched_stat_runtime(curtask, delta_exec, curr->vruntime);
        cgroup_account_cputime(curtask, delta_exec);
        account_group_exec_runtime(curtask, delta_exec);
    }

    account_cfs_rq_runtime(cfs_rq, delta_exec);
}
calc_delta_fair() 的实现:
static inline u64 calc_delta_fair(u64 delta, struct sched_entity *se)
{
    if (unlikely(se->load.weight != NICE_0_LOAD))
        delta = __calc_delta(delta, NICE_0_LOAD, &se->load);
    return delta;
}
对于 nice=0 的进程(weight=1024=NICE_0_LOAD),vruntime 增长速度等于实际时间。对于其他 nice 值,按权重比例调整。
update_min_vruntime() 的作用: cfs_rq->min_vruntime 是队列中所有实体的最小 vruntime(单调递增,不会倒退)。它的作用是为新唤醒的进程提供一个合理的 vruntime 初始值(避免新进程因为睡眠太久而 vruntime 过小,一醒来就长时间占用 CPU)。
4.4.4 入队:enqueue_entity()
当进程变为可运行(被唤醒、fork 完成、从睡眠中唤醒)时,调用 enqueue_entity() 将其加入 CFS 红黑树:
enqueue_entity(struct cfs_rq *cfs_rq, struct sched_entity *se, int flags)
{
    /* 1. 先更新当前进程的 vruntime(保证时间统计准确) */
    update_curr(cfs_rq);

    /* 2. 更新实体的权重(如果 nice 值改变了) */
    update_load_set(&se->load, se->load.weight);

    /* 3. 新唤醒的进程需要修正 vruntime */
    if (flags & ENQUEUE_WAKEUP) {
        place_entity(cfs_rq, se, 0);
        /* place_entity 将 se->vruntime 设置为 max(se->vruntime, cfs_rq->min_vruntime)
           避免睡眠太久的进程 vruntime 过小 */
    }

    /* 4. 统计等待时间 */
    if (schedstat_enabled()) {
        update_stats_enqueue(cfs_rq, se);
        check_spread(cfs_rq, se);
    }

    /* 5. 加入红黑树 */
    if (se != cfs_rq->curr)
        __enqueue_entity(cfs_rq, se);
    /* __enqueue_entity 将 se 插入红黑树(按 vruntime 排序),
       并更新 rb_root_cached 的最左节点缓存 */

    cfs_rq->nr_running++;
    se->on_rq = 1;

    /* 6. 层次化任务数在 enqueue_task_fair() 遍历调度实体时更新 */
    /* cfs_rq->h_nr_running++ */
}
place_entity() 的重要性: 如果一个进程睡眠了很长时间(如等待用户输入),它的 vruntime 会停留在睡眠前的值。当它被唤醒时,如果直接使用原来的 vruntime,它可能比队列中其他进程的 vruntime 小很多,导致它一醒来就长时间独占 CPU(因为 CFS 总是选 vruntime 最小的)。
place_entity() 解决这个问题:将新唤醒进程的 vruntime 调整为 max(原 vruntime, cfs_rq->min_vruntime - 唤醒补偿)。这样新唤醒进程不会因为睡眠而获得过多的 CPU 时间,同时给予一定的唤醒补偿(交互进程唤醒后能较快响应)。
4.4.5 出队:dequeue_entity()
当进程从可运行状态变为不可运行(睡眠、等待、退出)时,调用 dequeue_entity() 从红黑树移除:
dequeue_entity(struct cfs_rq *cfs_rq, struct sched_entity *se, int flags)
{
    update_curr(cfs_rq);  /* 先更新当前进程的时间 */

    /* 更新统计信息 */
    if (schedstat_enabled())
        update_stats_dequeue(cfs_rq, se, flags);

    /* 从红黑树移除 */
    if (se != cfs_rq->curr)
        __dequeue_entity(cfs_rq, se);

    se->on_rq = 0;
    cfs_rq->nr_running--;

    /* 更新 min_vruntime(如果移除的是最小 vruntime 的实体) */
    update_min_vruntime(cfs_rq);

    /* 层次化任务数在 dequeue_task_fair() 中更新:cfs_rq->h_nr_running-- */
}
4.4.6 选择下一个进程:pick_next_entity()
static struct sched_entity *pick_next_entity(struct cfs_rq *cfs_rq)
{
    struct sched_entity *se = __pick_first_entity(cfs_rq);
    /* __pick_first_entity 返回红黑树的最左节点(vruntime 最小) */

    struct sched_entity *left = se;

    /* 如果当前进程的 vruntime 比树中最小的还小,继续运行当前进程 */
    if (se && cfs_rq->curr && entity_before(cfs_rq->curr, se))
        se = cfs_rq->curr;

    /* 检查是否需要" Buddy" 调度(缓存友好性优化) */
    if (cfs_rq->next && se == cfs_rq->next) {
        /* 优先选择缓存热的进程 */
    }

    return se;
}
pick_next_entity() 的逻辑很简单:选择红黑树中 vruntime 最小的实体。但有一个优化:如果当前正在运行的进程的 vruntime 比树中最小的还小(说明当前进程刚开始运行不久),则继续运行当前进程,避免不必要的上下文切换。
4.4.7 周期性调度:task_tick_fair() → check_preempt_tick()
系统定时器每 HZ 次/秒(通常 250 或 1000)触发一次时钟中断,在时钟中断中调用调度类的 task_tick 方法,检查当前进程是否应该被抢占。
static void task_tick_fair(struct rq *rq, struct task_struct *curr, int queued)
{
    struct cfs_rq *cfs_rq = cfs_rq_of(&curr->se);

    /* 更新当前进程的 vruntime */
    update_curr(cfs_rq);

    /* 检查是否需要抢占当前进程 */
    if (cfs_rq->nr_running > 1)
        check_preempt_tick(cfs_rq, &curr->se);
}
check_preempt_tick() 详解:
static void check_preempt_tick(struct cfs_rq *cfs_rq, struct sched_entity *curr)
{
    unsigned long ideal_runtime, delta_exec;
    struct sched_entity *se;

    /* 1. 计算当前进程的理想运行时间
          ideal_runtime = sched_latency * weight / total_weight */
    ideal_runtime = sched_slice(cfs_rq, curr);

    /* 2. 计算当前进程本次已经运行的时间 */
    delta_exec = curr->sum_exec_runtime - curr->prev_sum_exec_runtime;

    /* 3. 如果实际运行时间超过了理想运行时间,触发抢占 */
    if (delta_exec > ideal_runtime) {
        resched_curr(rq_of(cfs_rq));
        /* 设置 TIF_NEED_RESCHED 标志,在中断返回时触发调度 */
        return;
    }

    /* 4. 即使没超过理想时间,如果红黑树中最小 vruntime 的进程
          比当前进程的 vruntime 小超过一个理想时间片,也触发抢占 */
    se = __pick_first_entity(cfs_rq);
    if (se && delta_exec > (sched_min_granularity / 2) &&
        entity_before(se, curr)) {
        /* 计算 vruntime 差距,如果差距足够大则抢占 */
        if (curr->vruntime - se->vruntime > ideal_runtime)
            resched_curr(rq_of(cfs_rq));
    }
}
调度参数:
源码中的规范化基准值是
sched_latency = 6ms、sched_min_granularity = 0.75ms、sched_wakeup_granularity = 1ms。默认
SCHED_TUNABLESCALING_LOG会根据在线 CPU 数(最多按 8 个 CPU 计)乘以1 + ilog2(ncpus),因此运行时有效值可能高于上述基准。sched_nr_latency由有效的sched_latency / sched_min_granularity得到,初始比值为 8。__sched_period()在可运行实体较少时返回有效sched_latency;超过阈值后返回nr_running × sched_min_granularity。
理想运行时间的计算:
ideal_runtime = sched_latency * weight / total_weight
即按权重比例分配调度延迟内的 CPU 时间。高权重进程获得更长的理想运行时间。
4.4.8 CFS 的唤醒抢占:check_preempt_wakeup()
当一个进程被唤醒时,如果它的优先级(vruntime)比当前运行的进程高,CFS 会立即抢占当前进程:
static void check_preempt_wakeup(struct rq *rq, struct task_struct *p, int wake_flags)
{
    struct task_struct *curr = rq->curr;
    struct sched_entity *se = &curr->se, *pse = &p->se;

    /* 如果当前进程是 idle 进程,直接抢占 */
    if (unlikely(task_has_idle_policy(curr)))
        goto preempt;

    /* 更新当前进程的 vruntime */
    update_curr(cfs_rq_of(se));

    /* 如果新唤醒进程的 vruntime 大于等于当前进程,不抢占 */
    if (entity_before(se, pse))
        return;

    /* 唤醒粒度检查:避免频繁的唤醒抢占
       如果当前进程运行时间不足 wakeup_granularity,不抢占 */
    if (sched_feat(NEXT_BUDDY) && !(wake_flags & WF_FORK)) {
        /* 设置 next buddy,下一次调度时优先选择 */
        set_next_buddy(pse);
    }

    /* 检查唤醒粒度 */
    if (wakeup_preempt_entity(se, pse) == 1) {
        /* vruntime 差距超过唤醒粒度,抢占 */
        goto preempt;
    }
    return;

preempt:
    resched_curr(rq);  /* 设置需要调度标志 */
}
唤醒粒度(sched_wakeup_granularity,规范化基准值 1ms,运行时同样受 tunable scaling 影响):新唤醒进程的 vruntime 必须比当前进程小超过唤醒粒度才触发抢占。这避免了频繁的唤醒抢占(如一个进程频繁唤醒另一个进程导致大量上下文切换)。
4.4.9 CFS 带宽控制:给一组进程限 CPU
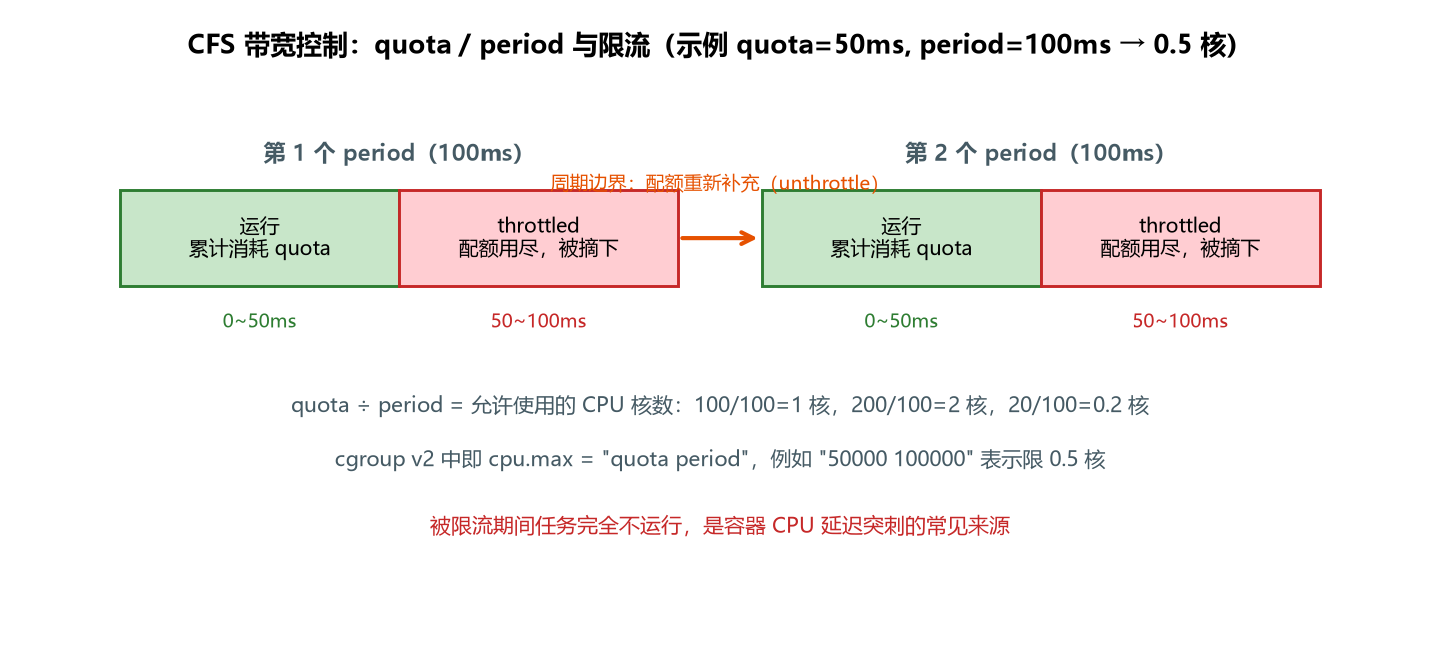
前面的 CFS 只保证"可运行进程之间按权重公平地分 CPU",并不限制一组进程最多能用多少。在容器、多租户场景下,往往需要"这个 cgroup 最多用 0.5 个核"。CFS 带宽控制(CFS Bandwidth Control,CONFIG_FAIR_GROUP_SCHED 的扩展,见 Documentation/scheduler/sched-bwc.rst)负责这件事。
它用"配额 + 周期"(quota / period)模型描述上限:
cpu.cfs_period_us:统计周期长度,默认 100ms(cgroup v2 里对应cpu.max的第二个数)。cpu.cfs_quota_us:一个周期内该组最多能运行的时间,默认 -1 表示不限制。周期内组内进程把 quota 用完后会被限流(throttle),从运行队列摘下、不再被调度,直到下个周期开始、配额重新补充才恢复(unthrottle)。
quota 与 period 的比值就是允许使用的 CPU 核数:
quota = period(如都是 100ms):平均最多 1 个核。
quota = 2 × period:最多 2 个核(可在两个核上同时跑满)。
quota = 0.2 × period(period 100ms、quota 20ms):最多 0.2 个核。
为降低多核间全局记账的锁竞争,配额不是逐 tick 下发,而是按"片"(slice)从全局池批量拨给每个 CPU 的本地运行队列,片大小由 sched_cfs_bandwidth_slice_us 控制(默认 5ms)。
这套机制正是 Docker/Kubernetes --cpus、cgroup v2 cpu.max 的底层:cpu.max = "50000 100000" 表示每 100ms 周期最多跑 50ms,即限 0.5 个核。被限流时任务会周期性"卡住",是容器里 CPU 延迟突刺的常见来源,排查时可看 cgroup 下的 cpu.stat(nr_periods、nr_throttled、throttled_time 分别是周期数、被限流次数、累计被限流时长)。
4.5 调度主流程:schedule() → __schedule()
4.5.1 调度的入口
调度可以被主动触发或被动触发:
主动调度:
进程调用
schedule()主动让出 CPU(如等待信号量、等待队列时)。yield()系统调用。
被动调度(抢占):
时钟中断中
check_preempt_tick()发现时间片用完,设置TIF_NEED_RESCHED。进程唤醒高优先级进程,
check_preempt_wakeup()设置TIF_NEED_RESCHED。系统调用/中断返回时检查
TIF_NEED_RESCHED,如果设置则调用schedule()。
4.5.2 __schedule() 详解
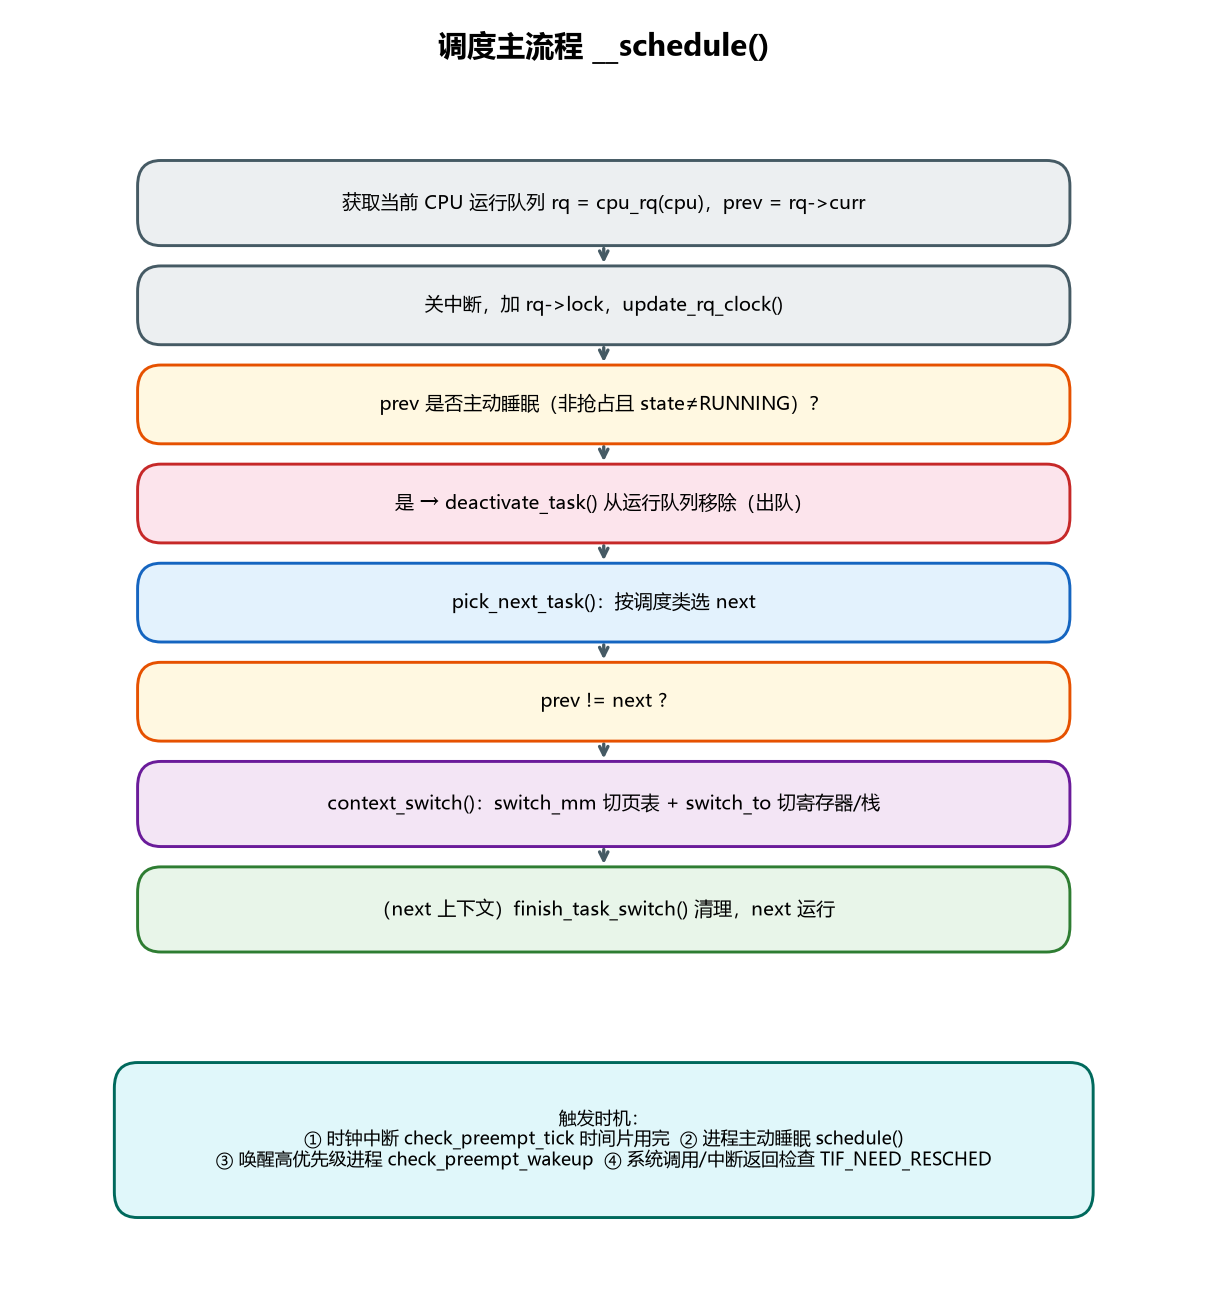
源码位置:kernel/sched/core.c
static void __sched notrace __schedule(unsigned int sched_mode)
{
    struct task_struct *prev, *next;
    unsigned long *switch_count;
    unsigned long prev_state;
    struct rq_flags rf;
    struct rq *rq;
    int cpu;

    /* 1. 获取当前 CPU 的运行队列和当前进程 */
    cpu = smp_processor_id();
    rq = cpu_rq(cpu);
    prev = rq->curr;

    /* 2. 清除高精度定时器 */
    if (sched_feat(HRTICK) || sched_feat(HRTICK_DL))
        hrtick_clear(rq);

    /* 3. 关中断,加运行队列锁 */
    local_irq_disable();
    rcu_note_context_switch(!!sched_mode);
    rq_lock(rq, &rf);
    smp_mb__after_spinlock();

    /* 4. 更新运行队列时钟 */
    rq->clock_update_flags <<= 1;
    update_rq_clock(rq);

    switch_count = &prev->nivcsw;  /* 非自愿切换计数 */

    /* 5. 处理当前进程的状态 */
    prev_state = READ_ONCE(prev->__state);
    if (!(sched_mode & SM_MASK_PREEMPT) && prev_state) {
        /* 非抢占式调度(主动睡眠)且当前进程不在 RUNNING 状态 */
        if (signal_pending_state(prev_state, prev)) {
            /* 有挂起信号,将进程状态改为 RUNNING,不睡眠 */
            WRITE_ONCE(prev->__state, TASK_RUNNING);
        } else {
            /* 真正睡眠:从运行队列移除 */
            prev->sched_contributes_to_load =
                (prev_state & TASK_UNINTERRUPTIBLE) &&
                !(prev_state & TASK_NOLOAD) &&
                !(prev->flags & PF_FROZEN);

            if (prev->sched_contributes_to_load)
                rq->nr_uninterruptible++;

            /* 从运行队列移除(deactivate_task → dequeue_entity) */
            deactivate_task(rq, prev, DEQUEUE_SLEEP | DEQUEUE_NOCLOCK);

            if (prev->in_iowait) {
                atomic_inc(&rq->nr_iowait);
                delayacct_blkio_start();
            }
        }
        switch_count = &prev->nvcsw;  /* 自愿切换计数 */
    }

    /* 6. 核心:选择下一个要运行的进程 */
    next = pick_next_task(rq, prev, &rf);
    /* pick_next_task 内部会调用 put_prev_task(将当前进程放回队列)
       然后按调度类优先级选择下一个进程 */

    clear_tsk_need_resched(prev);  /* 清除需要调度标志 */

    if (likely(prev != next)) {
        /* 7. 进程切换:执行上下文切换 */
        rq->nr_switches++;
        rq->curr = next;
        ++*switch_count;

        RCU_INIT_POINTER(rq->curr, next);
        rq = context_switch(rq, prev, next, &rf);
        /* context_switch 内部:
           - switch_mm() 切换页表
           - switch_to() 切换寄存器和栈
           switch_to 之后,当前执行流已经是 next:
           下面的代码在 next 被切换回来后执行(通过 finish_task_switch) */
    } else {
        /* 没有切换,仍然运行当前进程 */
        rq_unlock_irq(rq, &rf);
    }

    /* 8. (在 next 上下文中执行)完成切换后的清理 */
    balance_callback(rq);  /* 负载均衡回调 */
}
4.5.3 pick_next_task():按调度类优先级选择
pick_next_task(struct rq *rq, struct task_struct *prev, struct rq_flags *rf)
{
    const struct sched_class *class;
    struct task_struct *p;

    /* 优化快速路径:如果所有可运行进程都是 CFS 普通进程,
       直接调用 fair_sched_class.pick_next_task,避免遍历所有调度类 */
    if (likely(prev->sched_class <= &fair_sched_class &&
               rq->nr_running == rq->cfs.h_nr_running)) {
        p = fair_sched_class.pick_next_task(rq);
        if (p) return p;
        /* 如果 CFS 没有可运行进程,继续往下找(可能是 idle) */
    }

    /* 通用路径:从最高优先级调度类开始遍历 */
    for_each_class(class) {
        p = class->pick_next_task(rq);
        if (p) return p;
    }

    /* 所有调度类都没有可运行进程,返回 idle 进程 */
    return rq->idle;
}
for_each_class 宏:从 stop_sched_class 开始,沿 next 指针遍历到 idle_sched_class。第一个返回非 NULL 的调度类的进程被选中。这保证了高优先级调度类的进程总是优先于低优先级调度类的进程。
4.5.4 finish_task_switch():切换后的清理
context_switch() 中的 switch_to() 切换了执行流,被切换出去的进程(prev)在将来被重新调度回来时,会从 switch_to 的返回点继续执行。此时需要执行 finish_task_switch() 完成清理:
static struct rq *finish_task_switch(struct task_struct *prev)
    __releases(rq->lock)
{
    struct rq *rq = this_rq();

    /* 释放 prev 的引用计数 */
    if (prev)
        put_task_struct(prev);

    /* 完成 tick 的延迟处理 */
    tick_nohz_task_switch();

    /* 解锁运行队列 */
    rq_unlock_irq(rq, &rf);

    /* 执行负载均衡回调等 */
    return rq;
}
4.6 实时调度器(RT)简介
实时调度器用于对响应时间有严格要求的进程,使用 rt_sched_class,支持两种策略:
SCHED_FIFO(先进先出):
没有时间片,进程一旦运行就一直运行,直到主动放弃(睡眠/yield)或被更高优先级进程抢占。
同优先级的进程按 FIFO 顺序排队。
适合短时间、高优先级的实时任务。
SCHED_RR(时间片轮转):
有时间片(
sched_rr_timeslice,默认 100ms),用完后排队到同优先级队尾。同优先级的进程轮流运行。
适合需要公平分享 CPU 的实时任务。
实时优先级:1~99,数值越大优先级越高。实时进程的优先级总是高于普通进程(CFS),只要有实时进程可运行,CFS 进程就不会被调度。
运行队列:struct rt_rq,为每个优先级维护一个链表(queue[100]),同时维护一个优先级位图(active_prio),通过 __ffs() 快速找到最高优先级的非空队列。
4.7 截止时间调度器(Deadline)简介
截止时间调度器使用 dl_sched_class,基于 EDF(Earliest Deadline First,最早截止时间优先)算法:
每个实时任务有三个参数:
runtime(运行时间)、deadline(截止时间)、period(周期)。任务的 CPU 带宽 =
runtime / period,所有截止时间任务的总带宽不超过核数(默认限制为 95%,预留 5% 给普通进程)。调度时选择绝对截止时间最早的任务运行。
任务运行消耗
runtime,当runtime耗尽时,任务被推迟到下一个周期(deadline += period,runtime重置)。
EDF 是最优的单处理器实时调度算法,在任务总带宽不超过 100% 时,能保证所有任务的截止时间。
4.8 负载均衡
4.8.1 为什么需要负载均衡
在多 CPU 系统中,每个 CPU 有独立的运行队列。如果不做负载均衡,可能出现有的 CPU 繁忙(运行队列很长)而有的 CPU 空闲的情况,导致 CPU 资源浪费和进程响应延迟增加。
Linux 的负载均衡在两个时机触发:
周期性负载均衡:由
rebalance_domains()在定时器中定期执行,检查各 CPU 的负载情况,将繁忙 CPU 上的进程迁移到空闲 CPU。唤醒时均衡:进程被唤醒时,
select_task_rq()选择一个合适的 CPU 运行该进程:优先选择之前运行的 CPU(缓存亲和性,进程的内存数据可能还在该 CPU 的缓存中)。
如果该 CPU 繁忙,选择同调度域中空闲的 CPU。
如果没有空闲 CPU,选择负载最轻的 CPU。
4.8.2 调度域(Scheduling Domain)
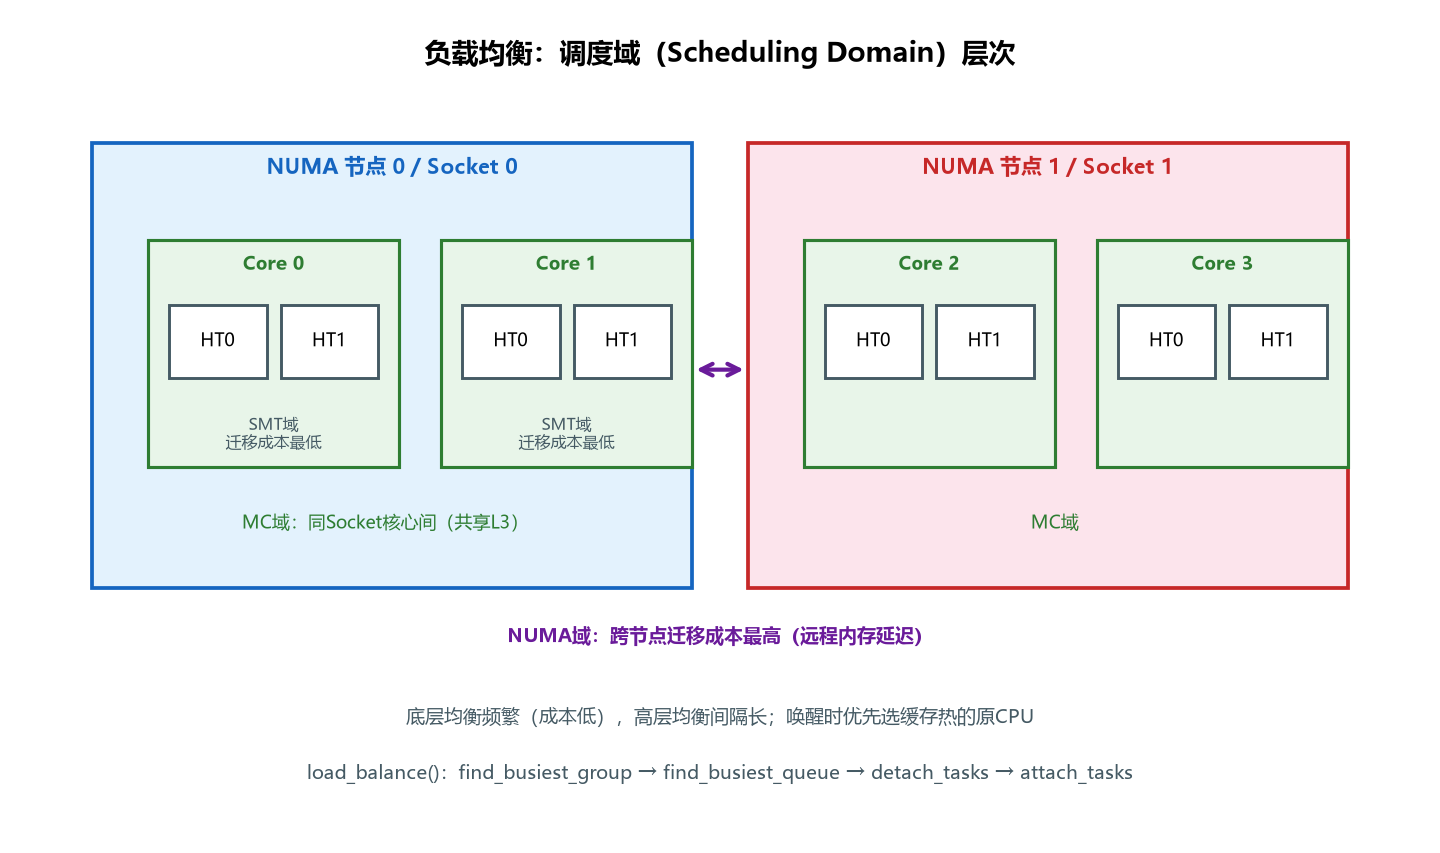
负载均衡按调度域(sched domain)层次进行,反映了 CPU 的拓扑结构:
NUMA 节点 0                    NUMA 节点 1
┌─────────────────────┐      ┌─────────────────────┐
│  Socket 0            │      │  Socket 1            │
│  ┌───────────────┐  │      │  ┌───────────────┐  │
│  │  Core 0       │  │      │  │  Core 2       │  │
│  │  (HT0, HT1)   │  │      │  │  (HT0, HT1)   │  │
│  └───────────────┘  │      │  └───────────────┘  │
│  ┌───────────────┐  │      │  ┌───────────────┐  │
│  │  Core 1       │  │      │  │  Core 3       │  │
│  │  (HT0, HT1)   │  │      │  │  (HT0, HT1)   │  │
│  └───────────────┘  │      │  └───────────────┘  │
└─────────────────────┘      └─────────────────────┘
调度域层次(从底层到高层):
SMT 域:同一物理核心的超线程之间,共享 L1/L2 缓存,迁移成本最低。
MC 域:同一物理芯片(Socket)的不同核心之间,共享 L3 缓存,迁移成本中等。
NUMA 域:不同 NUMA 节点之间,不共享缓存,跨节点内存访问延迟高,迁移成本最高。
每一层有不同的均衡间隔和迁移成本:底层均衡频繁(因为迁移成本低),高层均衡间隔长(因为迁移成本高,只在负载严重不均时才迁移)。
4.8.3 负载均衡的核心流程
load_balance()
  → find_busiest_group()  找到最繁忙的调度组
    → 计算各组的负载(加权运行队列长度 + 历史负载)
    → 找到最繁忙的组和最空闲的组
  → find_busiest_queue()  在最繁忙组中找到最繁忙的 CPU 队列
  → detach_tasks()        从繁忙运行队列挑选并摘下可迁移任务
    → can_migrate_task() 检查 CPU 亲和性、任务热度等条件
  → attach_tasks()        把暂存任务接入目标 CPU 的运行队列
负载计算:CFS 主要使用 PELT(Per-Entity Load Tracking):每个调度实体和运行队列都维护 runnable_avg、util_avg 等累计负载,按固定几何级数衰减(衰减周期约 32ms),既反映当前负载也保留近期历史,避免瞬时抖动造成无效迁移。负载均衡会结合调度实体和运行队列的 PELT 指标、CPU 容量与拓扑信息判断忙闲;而常说的 1/5/15 分钟平均负载(avenrun)是另一套全局统计,并不直接参与调度决策。
4.9 调度子系统总结
时钟中断 / 进程唤醒 / 主动睡眠
            │
            ▼
      schedule() → __schedule()
            │
            ▼
  处理当前进程状态(RUNNING / 睡眠出队)
            │
            ▼
  pick_next_task() 按调度类优先级选择
    ├─ stop_class    停机任务(最高优先级)
    ├─ dl_class      截止时间任务(EDF)
    ├─ rt_class      实时任务(FIFO/RR,优先级 1-99)
    ├─ fair_class    CFS 普通任务(默认)
    │     └─ 红黑树按 vruntime 排序,选最左节点
    └─ idle_class    空闲任务(最低优先级)
            │
            ▼
  context_switch()
    ├─ switch_mm()   切换页表(CR3),刷新 TLB
    └─ switch_to()   切换寄存器和内核栈(汇编)
            │
            ▼
  新进程开始运行
  update_curr() 持续更新 vruntime
  check_preempt_tick() 时间片用完 → 触发重新调度
本章要点:
模块化调度类:通过函数表实现多态,不同调度策略可插拔,高优先级调度类总是优先。
CFS 虚拟运行时间:用 vruntime 代替传统时间片,按权重公平分配 CPU 时间,红黑树高效选择最小 vruntime。
每 CPU 运行队列:避免全局锁竞争,每个 CPU 独立调度。
唤醒补偿与粒度控制:新唤醒进程给予一定补偿但不超过限度,最小运行粒度避免频繁切换。
层次化负载均衡:按 CPU 拓扑(SMT/MC/NUMA)分层均衡,迁移成本低的层均衡频繁。
DISCUSSION
评论