WRITING
第五章 存储子系统
第五章 存储子系统
5.1 操作系统原理:文件与 IO 的本质
5.1.1 为什么需要文件系统
磁盘等块设备提供的是原始的、按块编号的线性存储空间(如 LBA 0, 1, 2, …)。直接使用这种原始接口对应用程序很不方便:
应用需要自己管理哪些块存了什么数据。
应用需要自己处理数据的组织和索引。
不同应用之间无法共享数据。
数据的持久性、一致性、安全性无法保证。
**文件系统(File System)**在块设备之上提供了一层抽象,将原始的块存储组织为文件(File)和目录(Directory)的层次结构,为应用提供统一的、易用的接口。
5.1.2 文件的抽象
文件是操作系统提供的最重要的抽象之一。一个文件包含:
数据(Data):文件的内容,存储在磁盘的数据块中。
元数据(Metadata):文件的属性信息,如文件名、大小、创建时间、修改时间、权限、所有者、数据块位置等。元数据存储在 inode(索引节点)中。
关键概念:
inode(索引节点):文件系统中描述文件元数据的结构,在同一文件系统内,每个 inode 有相应的 inode 号。inode 不包含文件名,文件名由目录项(dentry)管理。
目录项(dentry):文件名到 inode 的映射,目录本身也是一种文件,内容是目录项的列表。
硬链接(Hard Link):多个文件名指向同一个 inode,通过 inode 的链接计数(
i_nlink)管理。符号链接(Symbolic Link):一个特殊的文件,内容是另一个文件的路径字符串。
5.1.3 IO 的方式
操作系统提供多种 IO 方式:
阻塞 IO(Blocking IO):进程发起 IO 后睡眠,等待 IO 完成。简单但效率低(进程被阻塞无法做其他事)。
非阻塞 IO(Non-blocking IO):进程发起 IO 后立即返回,如果数据未就绪则返回错误。进程需要轮询,CPU 利用率低。
IO 多路复用(IO Multiplexing):
select/poll/epoll,一个进程同时监控多个文件描述符,等待其中任意一个就绪。高并发服务器的核心技术。异步 IO(Asynchronous IO):进程发起 IO 后立即返回,IO 在后台完成,完成后通知进程(信号或回调)。Linux 的
io_uring是现代异步 IO 的代表。内存映射 IO(Memory-mapped IO):
mmap()将文件映射到进程的虚拟地址空间,通过读写内存来访问文件,无需read/write系统调用。
5.1.4 页缓存(Page Cache)
**页缓存(Page Cache)**是 Linux 存储性能的核心机制。内核将磁盘文件的内容缓存在内存页中:
读操作:先查页缓存,命中则直接从内存返回(微秒级);未命中则从磁盘读取(毫秒级),同时将读入的页放入页缓存。
写操作:先写页缓存(内存),标记为脏页(Dirty),立即返回;脏页由内核线程异步写回磁盘(write-back 机制)。
页缓存的好处:
减少磁盘 IO:频繁访问的文件数据驻留在内存,避免重复读盘。
提高写性能:写操作只写内存不写盘,延迟极低。
预读(Read-ahead):检测到顺序读时,提前读取后续页面,提高命中率。
共享:多个进程映射同一个文件时,共享页缓存,节省内存。
5.2 Linux 存储栈全景
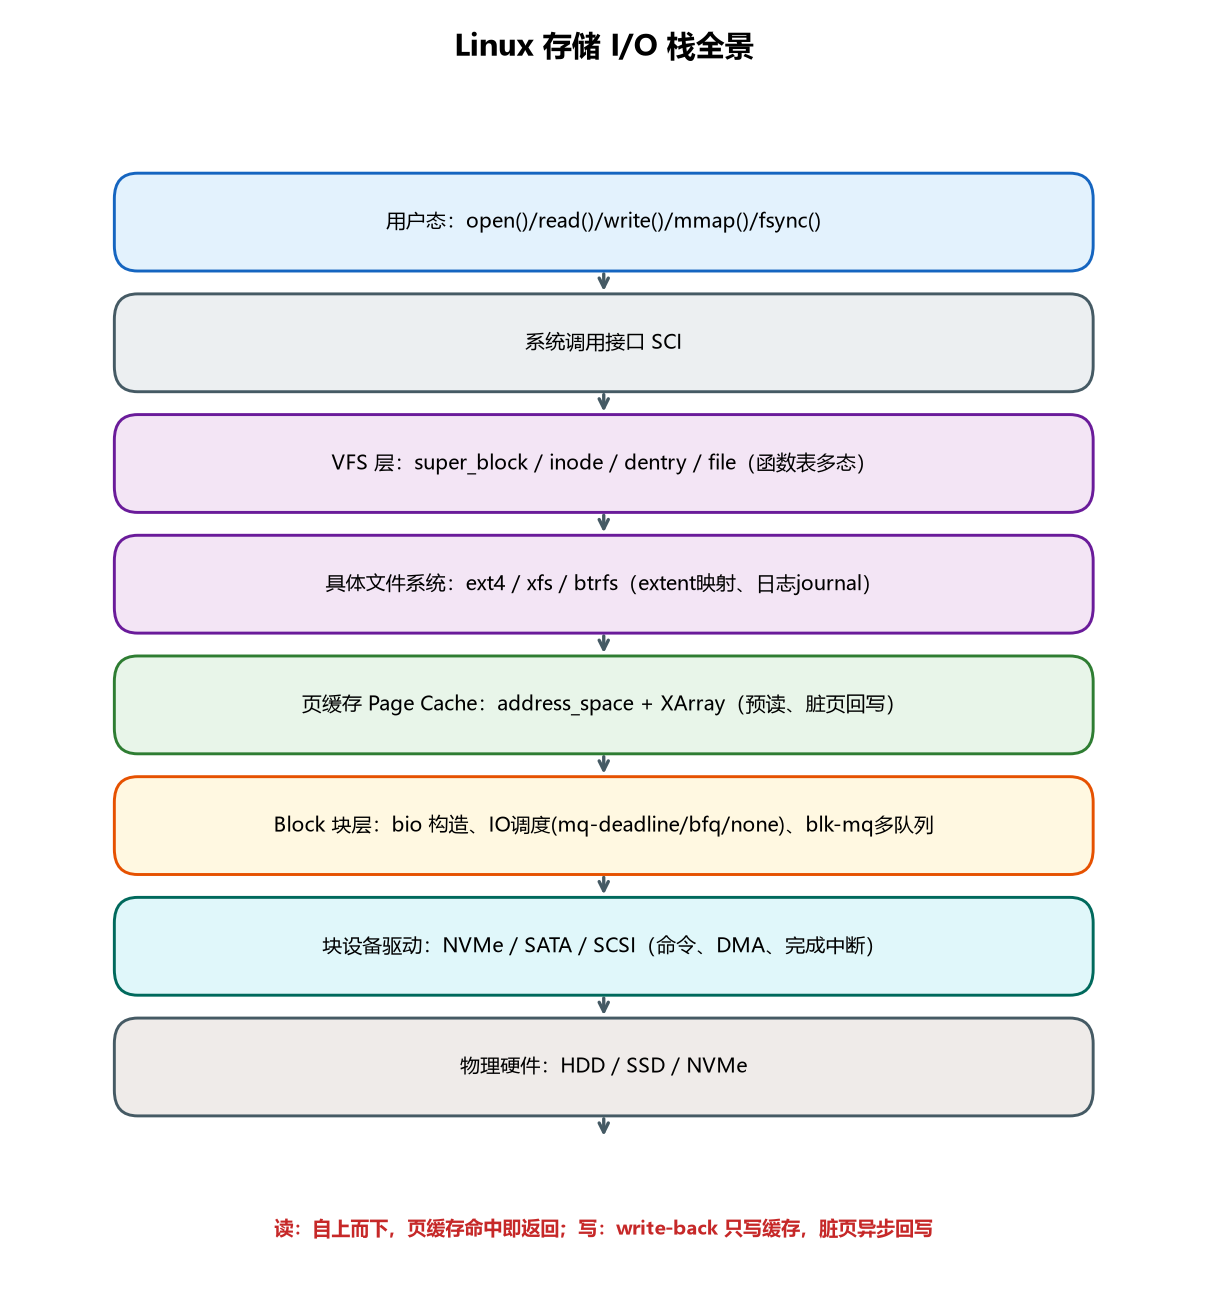
Linux 存储栈从上层到下层依次为:
┌─────────────────────────────────────────────────────────┐
│                    用户态应用程序                            │
│         open()/read()/write()/mmap()/fsync()             │
├─────────────────────────────────────────────────────────┤
│              系统调用接口(SCI)                              │
├─────────────────────────────────────────────────────────┤
│  VFS 层(fs/)                                             │
│  统一文件操作接口,超级块/inode/dentry/file,函数表多态      │
├─────────────────────────────────────────────────────────┤
│  文件系统层(fs/ext4/, fs/xfs/, fs/btrfs/, ...)          │
│  inode 管理、数据块映射(extent/位图/间接块)、日志        │
├─────────────────────────────────────────────────────────┤
│  页缓存层(mm/filemap.c)                                   │
│  address_space + XArray,文件内容的内存缓存、预读、回写     │
├─────────────────────────────────────────────────────────┤
│  Block 层(block/)                                         │
│  bio 构造、IO 调度(mq-deadline/kyber/bfq/none)、        │
│  blk-mq 多队列、请求队列、流量控制                           │
├─────────────────────────────────────────────────────────┤
│  块设备驱动层(drivers/block/, drivers/nvme/, ...)        │
│  与硬件交互,提交 IO 命令到设备,处理完成中断               │
├─────────────────────────────────────────────────────────┤
│                    物理硬件                                  │
│         HDD / SSD / NVMe /  RAID /  SAN                    │
└─────────────────────────────────────────────────────────┘
5.3 VFS 虚拟文件系统
5.3.1 VFS 的设计思想
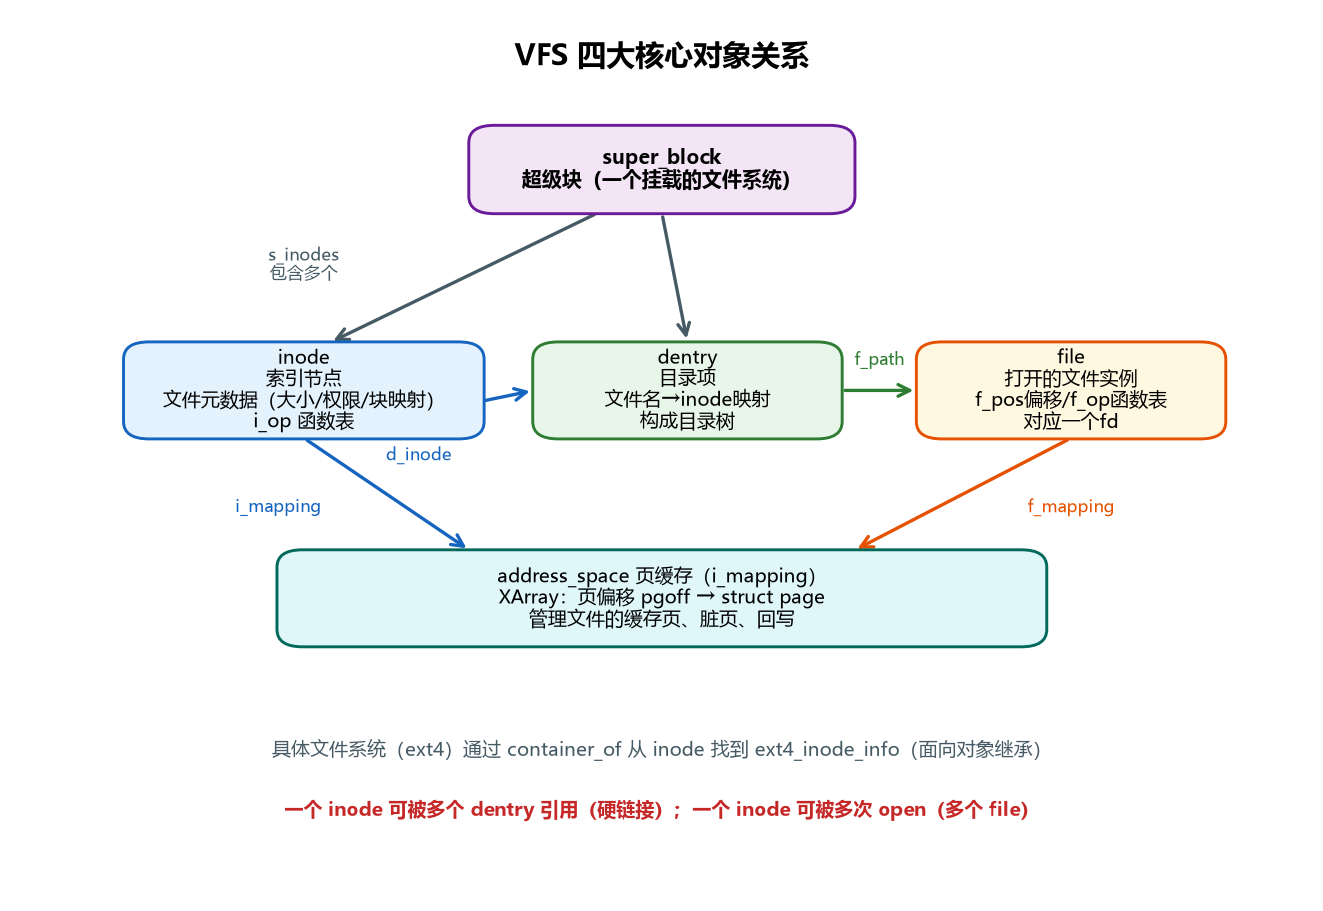
**VFS(Virtual File System,虚拟文件系统)**是 Linux 文件系统的核心抽象层。它的目标是:
为用户态提供统一的文件操作接口(open/read/write/close 等)。
支持多种具体文件系统(ext4、xfs、btrfs、vfat、nfs 等)共存。
通过面向对象的函数表实现多态:VFS 定义通用接口,具体文件系统实现函数表。
VFS 定义了四个核心对象:
对象 | 作用 | 对应结构 | 函数表 |
|---|---|---|---|
超级块(Super Block) | 一个已挂载的文件系统实例 |
|
|
索引节点(inode) | 一个文件的元数据 |
|
|
目录项(dentry) | 路径组件(文件名→inode 映射) |
|
|
文件(file) | 一个打开的文件实例 |
|
|
5.3.2 struct super_block — 超级块
源码位置:include/linux/fs.h
超级块代表一个已挂载的文件系统实例,存储文件系统的全局信息:
struct super_block {
    struct list_head s_list;        /* 全局超级块链表 */
    dev_t s_dev;                     /* 设备号 */
    unsigned long s_blocksize;       /* 块大小 */
    unsigned char s_blocksize_bits;  /* 块大小的位数(log2) */
    unsigned long long s_maxbytes;   /* 最大文件大小 */
    struct file_system_type *s_type; /* 文件系统类型(如 ext4) */
    const struct super_operations *s_op;  /* 超级块操作函数表 */
    unsigned long s_flags;           /* 挂载标志(MS_RDONLY 等) */
    unsigned long s_magic;           /* 文件系统魔数 */
    struct dentry *s_root;           /* 根目录的 dentry */
    struct rw_semaphore s_umount;    /* 卸载信号量 */
    int s_count;                      /* 引用计数 */
    int s_active;                     /* 活跃引用计数 */
    struct list_head s_inodes;        /* 所有 inode 链表 */
    struct list_head s_mounts;        /* 挂载点链表 */
    void *s_fs_info;                  /* 文件系统私有数据(ext4 的 ext4_sb_info) */
    /* ... */
};
超级块操作函数表 super_operations:
struct super_operations {
    struct inode *(*alloc_inode)(struct super_block *sb);  /* 分配 inode */
    void (*destroy_inode)(struct inode *);                  /* 销毁 inode */
    void (*dirty_inode)(struct inode *, int flags);         /* 标记 inode 脏 */
    int (*write_inode)(struct inode *, struct writeback_control *);  /* 写 inode 到磁盘 */
    int (*drop_inode)(struct inode *);                       /* 释放 inode */
    void (*evict_inode)(struct inode *);                     /* 清除 inode */
    void (*put_super)(struct super_block *);                 /* 释放超级块 */
    int (*sync_fs)(struct super_block *sb, int wait);        /* 同步文件系统 */
    int (*freeze_fs)(struct super_block *);                  /* 冻结文件系统 */
    int (*unfreeze_fs)(struct super_block *);                /* 解冻 */
    int (*statfs)(struct dentry *, struct kstatfs *);        /* 文件系统统计 */
    /* ... */
};
5.3.3 struct inode — 索引节点
源码位置:include/linux/fs.h
inode 是文件系统中描述一个文件的元数据结构(不包含文件名):
struct inode {
    umode_t i_mode;              /* 文件类型和权限(S_IFREG/S_IFDIR/S_IFLNK 等 + rwx) */
    unsigned short i_opflags;
    kuid_t i_uid;                 /* 所有者 UID */
    kgid_t i_gid;                 /* 所属组 GID */
    unsigned int i_flags;         /* inode 标志(S_SYNC/S_DIRSYNC 等) */

    const struct inode_operations *i_op;  /* inode 操作函数表 */
    struct super_block *i_sb;             /* 所属超级块 */
    struct address_space *i_mapping;      /* 页缓存地址空间 */
    struct address_space i_data;           /* 内嵌的地址空间(通常 i_mapping = &i_data) */

    unsigned long i_ino;          /* inode 号 */
    __u32 i_nlink;                 /* 硬链接数 */
    off_t i_size;                  /* 文件大小(字节) */
    struct timespec64 i_atime;     /* 访问时间 */
    struct timespec64 i_mtime;     /* 修改时间 */
    struct timespec64 i_ctime;     /* 状态改变时间 */

    spinlock_t i_lock;             /* inode 锁 */
    atomic_t i_count;               /* 引用计数 */
    struct hlist_node i_hash;       /* inode 哈希表节点(通过 inode 号快速查找) */
    struct list_head i_lru;         /* LRU 链表节点(用于 inode 缓存回收) */
    struct list_head i_sb_list;     /* 超级块的 inode 链表节点 */
    struct list_head i_wb_list;     /* 回写链表节点 */

    /* 块设备相关 */
    sector_t i_blocks;              /* 占用的块数(512 字节为单位) */
    unsigned short i_bytes;         /* 最后一个块的有效字节数 */

    void *i_private;                /* 文件系统私有数据(ext4 的 ext4_inode_info) */
    /* ... */
};
inode 操作函数表 inode_operations:
struct inode_operations {
    struct dentry *(*lookup)(struct inode *, struct dentry *, unsigned int);  /* 目录查找 */
    int (*create)(struct inode *, struct dentry *, umode_t, bool);             /* 创建文件 */
    int (*link)(struct dentry *, struct inode *, struct dentry *);             /* 硬链接 */
    int (*unlink)(struct inode *, struct dentry *);                             /* 删除文件 */
    int (*symlink)(struct inode *, struct dentry *, const char *);              /* 符号链接 */
    int (*mkdir)(struct inode *, struct dentry *, umode_t);                     /* 创建目录 */
    int (*rmdir)(struct inode *, struct dentry *);                              /* 删除目录 */
    int (*mknod)(struct inode *, struct dentry *, umode_t, dev_t);             /* 创建设备文件 */
    int (*rename)(struct inode *, struct dentry *, struct inode *, struct dentry *, unsigned int);  /* 重命名 */
    int (*setattr)(struct user_namespace *, struct dentry *, struct iattr *);  /* 设置属性(chmod/chown 等) */
    int (*getattr)(const struct path *, struct kstat *, u32, unsigned int);    /* 获取属性 */
    ssize_t (*listxattr)(struct dentry *, char *, size_t);                      /* 列出扩展属性 */
    /* ... */
};
设计要点:
i_mode的高 4 位表示文件类型(S_IFREG普通文件、S_IFDIR目录、S_IFLNK符号链接、S_IFCHR字符设备、S_IFBLK块设备、S_IFIFO管道、S_IFSOCKsocket),低 12 位是权限位(rwxrwxrwx + setuid/setgid/sticky)。i_mapping指向该文件的页缓存地址空间。对于普通文件,i_mapping = &i_data(内嵌的 address_space)。对于设备文件,i_mapping指向块设备的地址空间。i_private是文件系统私有数据指针,ext4 用它指向ext4_inode_info(包含 ext4 特有的 extent 树、预分配信息等)。这是面向对象的"继承":ext4_inode_info内嵌struct inode,通过container_of从 inode 找到 ext4_inode_info。
5.3.4 struct file — 打开的文件
struct file {
    struct path f_path;            /* 文件路径(dentry + vfsmount) */
    struct inode *f_inode;         /* 关联的 inode(f_path.dentry->d_inode 的缓存) */
    const struct file_operations *f_op;  /* 文件操作函数表 */
    unsigned int f_flags;           /* 打开标志(O_RDONLY/O_WRONLY/O_APPEND/O_NONBLOCK 等) */
    fmode_t f_mode;                 /* 访问模式(FMODE_READ/FMODE_WRITE) */
    loff_t f_pos;                   /* 当前文件偏移(读写位置) */
    struct fown_struct f_owner;     /* 所有者(用于 SIGIO 异步通知) */
    void *private_data;             /* 驱动/文件系统私有数据 */
    struct address_space *f_mapping; /* 页缓存(通常等于 inode->i_mapping) */
    /* ... */
};
文件操作函数表 file_operations:
struct file_operations {
    struct module *owner;
    loff_t (*llseek)(struct file *, loff_t, int);            /* 定位(lseek) */
    ssize_t (*read)(struct file *, char __user *, size_t, loff_t *);  /* 读 */
    ssize_t (*write)(struct file *, const char __user *, size_t, loff_t *);  /* 写 */
    ssize_t (*read_iter)(struct kiocb *, struct iov_iter *);  /* 迭代读(现代接口) */
    ssize_t (*write_iter)(struct kiocb *, struct iov_iter *);  /* 迭代写(现代接口) */
    int (*iterate)(struct file *, struct dir_context *);      /* 读目录 */
    unsigned int (*poll)(struct file *, struct poll_table_struct *);  /* poll/select/epoll */
    long (*unlocked_ioctl)(struct file *, unsigned int, unsigned long);  /* ioctl */
    long (*compat_ioctl)(struct file *, unsigned int, unsigned long);    /* 32位兼容 ioctl */
    int (*mmap)(struct file *, struct vm_area_struct *);       /* 内存映射 */
    int (*open)(struct inode *, struct file *);                /* 打开 */
    int (*flush)(struct file *, fl_owner_t id);                /* 刷新 */
    int (*release)(struct inode *, struct file *);             /* 关闭 */
    int (*fsync)(struct file *, loff_t, loff_t, int datasync);  /* 同步到磁盘 */
    int (*aio_fsync)(struct kiocb *, int datasync);            /* 异步 fsync */
    int (*fadvise)(struct file *, loff_t, loff_t, int);       /* 预读建议 */
    /* ... */
};
关键设计:
f_pos是文件偏移,每次 read/write 后自动更新。lseek()可以修改它。O_APPEND模式下每次写都定位到文件末尾。private_data是驱动/文件系统的私有数据,设备驱动常用它存储设备上下文。现代内核推荐使用
read_iter/write_iter代替传统的read/write,因为迭代器接口支持分散/聚集 IO(多个缓冲区)和异步 IO(io_uring)。
5.3.5 struct address_space — 页缓存地址空间
struct address_space {
    struct inode *host;            /* 所属 inode */
    struct xarray i_pages;         /* 页缓存(XArray,替代了原来的 radix_tree) */
    gfp_t gfp_mask;                /* 分配页的标志 */
    atomic_t i_mmap_writable;      /* 可写映射计数 */
    struct rb_root_cached i_mmap;  /* 映射该文件的所有 VMA 的区间树(优先搜索树) */
    struct rw_semaphore i_mmap_rwsem; /* 保护 i_mmap */
    unsigned long nrpages;          /* 缓存页数 */
    const struct address_space_operations *a_ops;  /* 地址空间操作函数表 */
    unsigned long flags;            /* 标志(AS_EIO/AS_ENOSPC 等) */
    /* ... */
};
地址空间操作函数表 address_space_operations:
struct address_space_operations {
    int (*writepage)(struct page *, struct writeback_control *);       /* 写一页 */
    int (*readpage)(struct file *, struct page *);                     /* 读一页 */
    int (*writepages)(struct address_space *, struct writeback_control *); /* 批量回写 */
    int (*set_page_dirty)(struct page *);                              /* 标记页脏 */
    int (*readpages)(struct file *, struct address_space *,
                     struct list_head *, unsigned int);                /* 旧式预读接口 */
    void (*readahead)(struct readahead_control *);                     /* 预读接口 */
    int (*write_begin)(struct file *, struct address_space *,
                       loff_t, unsigned int, unsigned int,
                       struct page **, void **);
    int (*write_end)(struct file *, struct address_space *,
                     loff_t, unsigned int, unsigned int,
                     struct page *, void *);
    void (*invalidatepage)(struct page *, unsigned int, unsigned int);
    int (*releasepage)(struct page *, gfp_t);
    sector_t (*bmap)(struct address_space *, sector_t);
    void (*freepage)(struct page *);
    /* ... */
};
页缓存的核心数据结构 XArray:
早期内核使用 radix tree(基数树)管理页缓存,5.15 版本已替换为 XArray(更高效、更简洁的实现)。
XArray 是一个稀疏数组,索引是文件内的页偏移(
pgoff_t),值是struct page指针。支持标记(mark):如
PAGECACHE_TAG_DIRTY(脏页)、PAGECACHE_TAG_WRITEBACK(正在回写),可以快速遍历所有脏页。查找会沿 XArray 的分层节点按索引逐级下降;树高受索引位宽限制,并随当前索引范围变化。它不是“无论规模都只访问一两次”的固定常数操作。
5.4 读文件完整流程
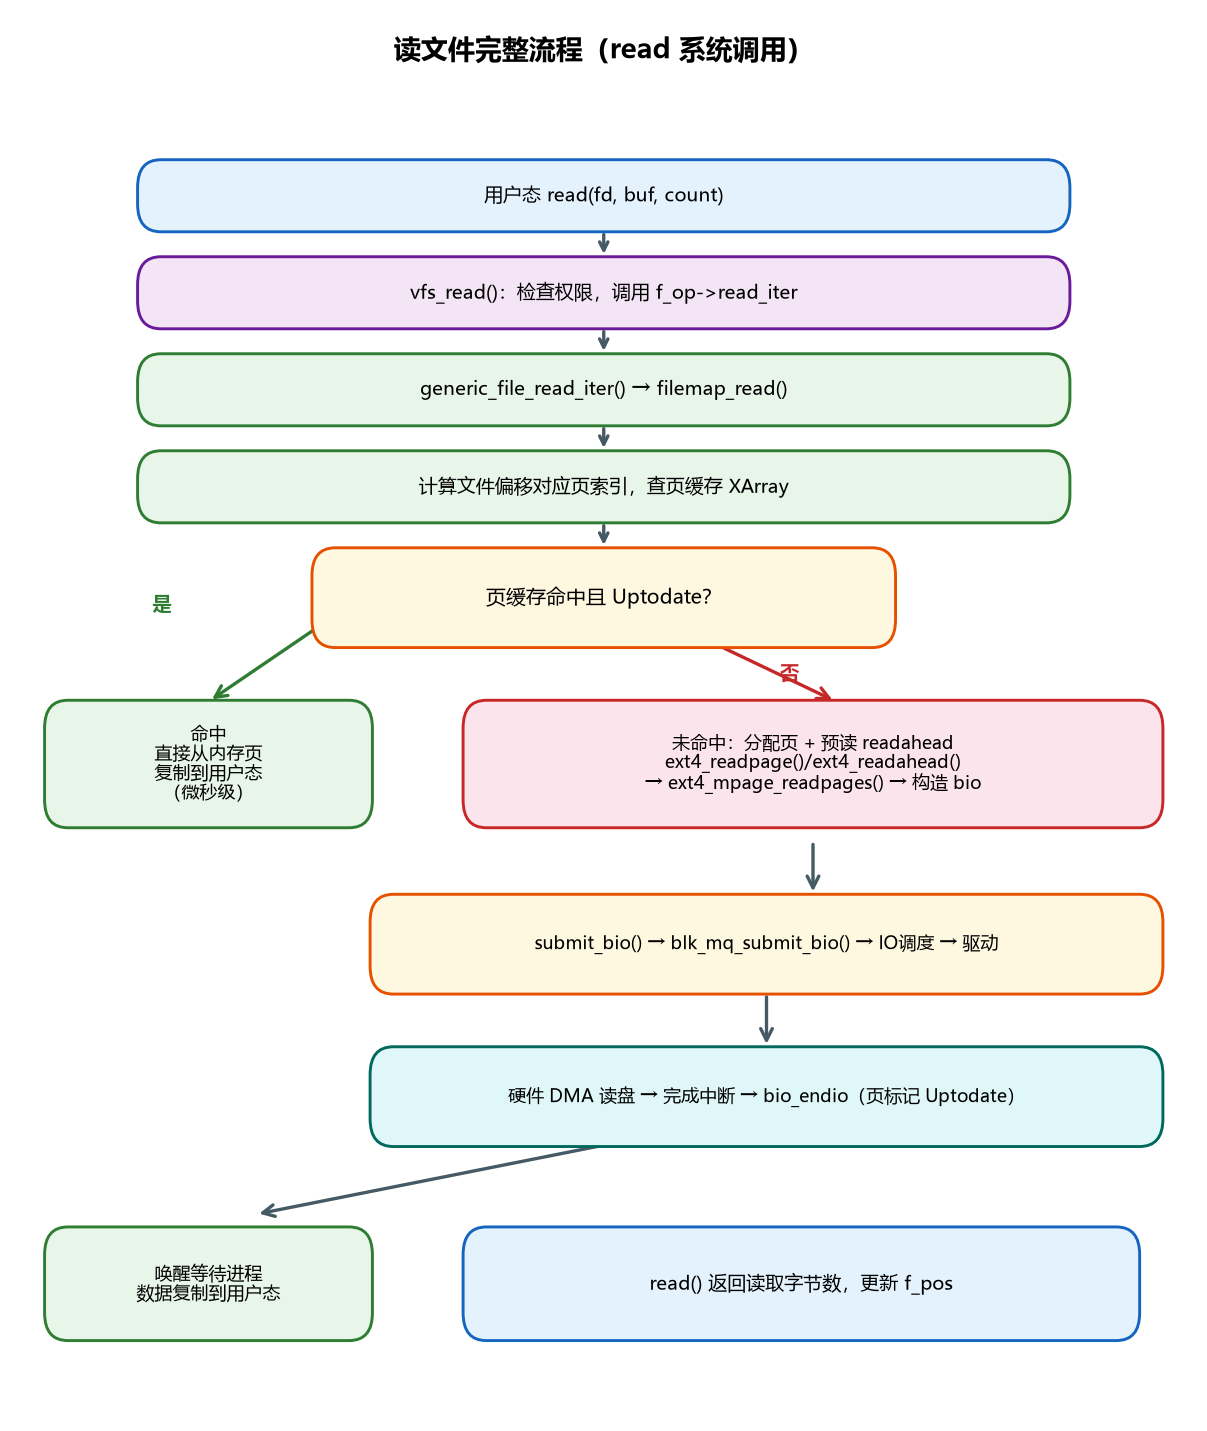
以 read() 系统调用为例,跟踪从用户态到磁盘的完整路径:
5.4.1 系统调用入口
用户态 read(fd, buf, count)
  │
  ▼ 系统调用
sys_read() → ksys_read()
  │
  ▼
vfs_read()  —— VFS 层
  │  1. 检查文件描述符 fd 是否有效
  │  2. 检查文件访问模式(是否可读)
  │  3. 调用 file->f_op->read 或 read_iter
  │
  ▼
5.4.2 VFS 层:vfs_read()
ssize_t vfs_read(struct file *file, char __user *buf, size_t count, loff_t *pos)
{
    /* 检查访问权限 */
    if (!(file->f_mode & FMODE_READ))
        return -EBADF;

    /* 检查文件位置 */
    if (unlikely(!access_ok(buf, count)))
        return -EFAULT;

    /* 调用文件系统的读操作 */
    if (file->f_op->read)
        ret = file->f_op->read(file, buf, count, pos);
    else if (file->f_op->read_iter)
        ret = new_sync_read(file, buf, count, pos);
    else
        ret = -EINVAL;

    /* 通知监控、更新统计 */
    if (ret > 0) {
        fsnotify_access(file);
        add_rchar(current, ret);
    }
    return ret;
}
5.4.3 通用读:generic_file_read_iter() → filemap_read()
对于普通文件,ext4 的 file_operations.read_iter 指向 generic_file_read_iter(),最终调用 filemap_read():
generic_file_read_iter()
  → filemap_read()  —— 页缓存层(mm/filemap.c)
    │
    ├─ 1. 计算文件偏移对应的起始页索引和结束页索引
    │
    ├─ 2. 遍历需要读取的每一页:
    │     ├─ 在页缓存(XArray)中查找页
    │     ├─ 命中且页有效(Uptodate)→ 直接从内存页复制数据到用户态
    │     ├─ 未命中 → 分配页,发起磁盘读
    │     │     → page_cache_sync_readahead() / page_cache_async_readahead()
    │     │     → 预读算法:检测顺序读模式,提前读取后续页面
    │     │     → 单页补读走 mapping->a_ops->readpage();成批预读走 a_ops->readahead()
    │     │     → 构造 bio,提交给块层
    │     │     → 等待 IO 完成(页锁)
    │     └─ 数据从页缓存复制到用户态缓冲区
    │
    └─ 3. 更新文件偏移 f_pos,返回读取字节数
5.4.4 预读(Read-ahead)机制
预读是提高读性能的关键技术:
当检测到进程在顺序读文件时(连续访问的页号递增),内核会提前读取后续页面(通常一次预读 128KB~2MB)。
预读是异步的:预读请求提交后,进程只需等待当前需要的页,后续页在后台读取。
预读窗口动态调整:顺序读时窗口逐渐增大(最大 2MB),随机读时窗口缩小甚至禁用预读。
预读的核心函数:
ondemand_readahead()(mm/readahead.c),根据访问模式计算预读窗口大小。
5.4.5 文件系统层:ext4_readpage() / ext4_readahead()
在 Linux 5.15.220 中,ext4 仍使用 page 接口而不是后续版本的 folio 读接口:单页读取进入 ext4_readpage(),预读进入 ext4_readahead();两者都复用 ext4_mpage_readpages() 完成普通文件数据读取。主要工作包括:
通过 ext4 的 extent 树查找文件逻辑块对应的磁盘物理块号。
构造
bio(块 IO 请求),将连续的物理块合并为一个 bio。调用
submit_bio()提交给块层。
extent 映射:ext4 使用 extent(区段)代替传统的间接块映射。一个 extent 描述一段连续的物理块(起始块号 + 长度),比间接块更高效(大文件只需要少量 extent,而间接块需要多级索引块)。extent 存储在 inode 的 i_block 字段中(内联 extent,最多 4 个),超过 4 个 extent 时使用 extent 树(B+ 树)存储。
5.4.6 块层:submit_bio() → blk_mq_submit_bio()
submit_bio()  —— block/blk-core.c
  │  1. IO 统计(PGPGIN/PGPGOUT)
  │  2. cgroup IO 节流检查
  │
  ▼
submit_bio_noacct()
  → __submit_bio()
    → blk_mq_submit_bio()  —— 多队列块层
      │
      ├─ 1. 为 bio 分配请求标签(tag)
      ├─ 2. 将 bio 转换为 request(或直接 bio-based)
      ├─ 3. 进入 IO 调度器(如果启用了调度器)
      │     - mq-deadline:按 LBA 排序 + 截止时间保证
      │     - kyber:基于延迟的调度
      │     - bfq:预算公平队列,按进程分配 IO 带宽
      │     - none:不调度,直接提交(NVMe 默认)
      ├─ 4. 调用驱动的 queue_rq() 将请求提交到硬件队列
      └─ 5. 触发硬件 DMA 传输
5.4.7 驱动与硬件
块设备驱动(如 NVMe 驱动):
将 block 层的 request 转换为设备特定的命令(如 NVMe 的 SQE,Submission Queue Entry)。
将命令写入设备的提交队列(Submission Queue),通过门铃寄存器(Doorbell)通知设备。
设备执行 DMA,将数据从磁盘传输到内存(读)或从内存传输到磁盘(写)。
完成后,设备将完成队列条目(CQE,Completion Queue Entry)写入完成队列,触发中断。
驱动中断处理程序处理 CQE,调用
bio_endio()通知 bio 完成。bio_endio()调用 bio 的bi_end_io回调(对于读,是mpage_end_io,标记页为 Uptodate,解锁页,唤醒等待的进程)。
5.4.8 完成与返回
IO 完成后:
页被标记为
PG_uptodate(数据有效)。页锁被释放,等待在页上的进程被唤醒。
filemap_read()将数据从页缓存复制到用户态缓冲区。更新文件偏移
f_pos。read()返回复制的字节数。
5.5 写文件完整流程
5.5.1 Write-back 机制
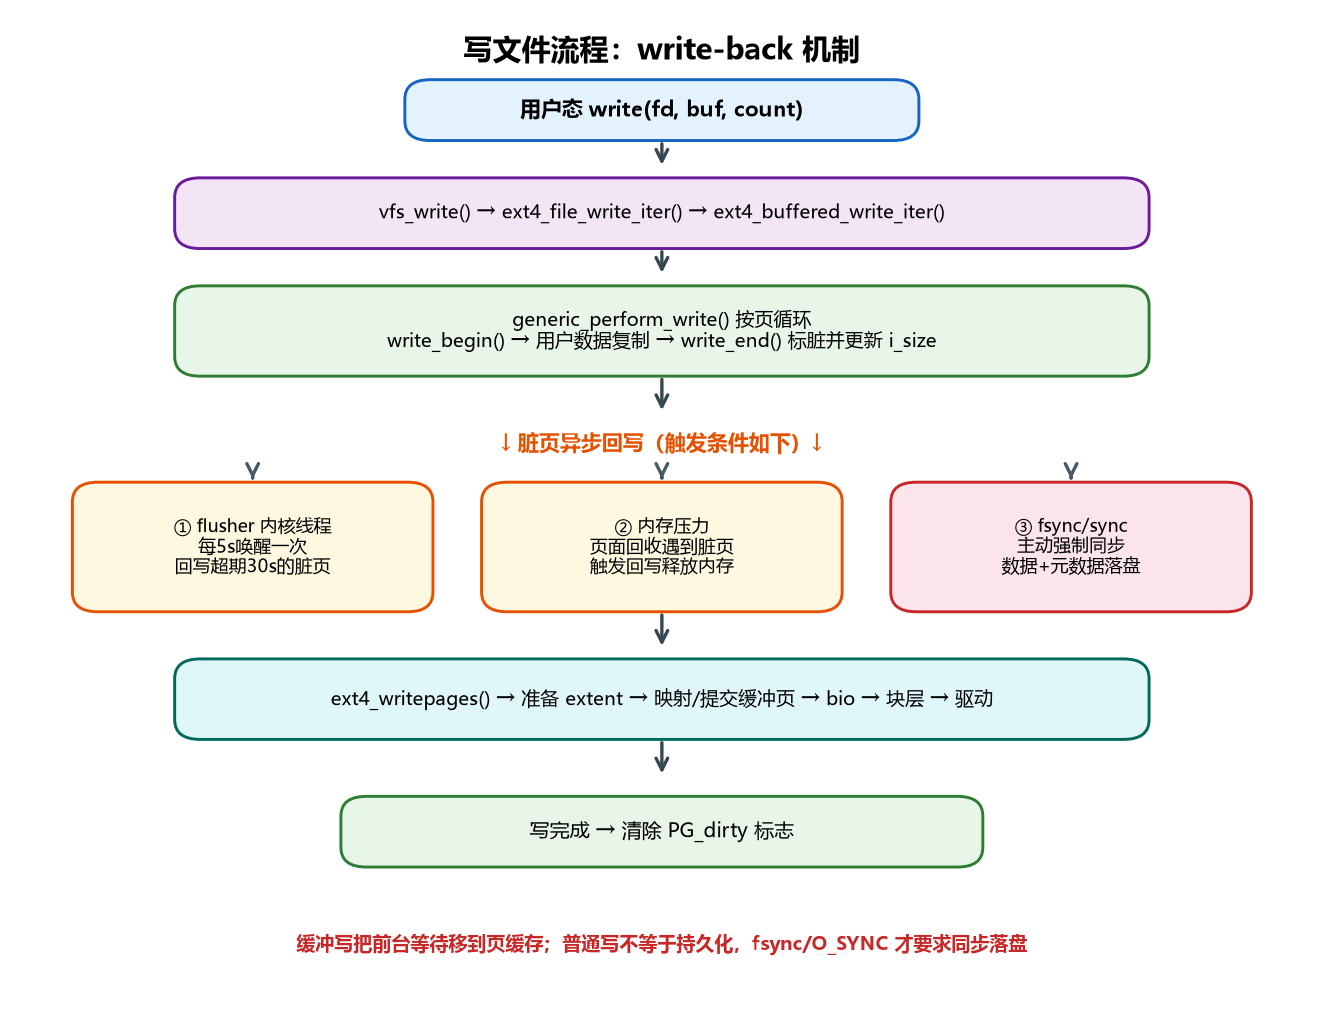
Linux 默认使用 write-back(写回) 机制:
写操作只写页缓存(内存),标记页为脏(Dirty),立即返回。
脏页由内核线程(
flusher/bdi_writeback)异步批量写回磁盘。缓冲写把多数前台写入的等待从设备完成路径移到页缓存更新路径;实际加速幅度取决于介质、队列、写入模式以及是否要求同步持久化,不能用固定倍数概括。
代价是异常断电时可能丢失最近的写入(未刷盘的脏页)。
脏页回写由一组阈值共同控制(默认值见 mm/page-writeback.c,参数语义见 Documentation/admin-guide/sysctl/vm.rst):
周期性回写:
flusher线程每dirty_writeback_centisecs(默认 500,即 5 秒)唤醒一次,把脏龄超过dirty_expire_centisecs(默认 3000,即 30 秒)的脏页写回。要区分这两个值:5 秒是唤醒周期,30 秒是"多脏才算老、本次需要回写"的年龄门槛。后台比例阈值:脏页占可用内存的比例达到
dirty_background_ratio(默认 10%)时,后台 flusher 开始异步回写,写进程本身不被阻塞。硬比例阈值:达到
vm_dirty_ratio(默认 20%)时,正在写的进程自己进入同步回写、被限流(throttle),直到脏页比例降下来,以此给磁盘回写留出追赶时间。内存压力:内存不足时,页面回收路径遇到脏页也会触发回写。
主动同步:
fsync()/fdatasync()/sync()系统调用主动回写。
5.5.2 写流程
用户态 write(fd, buf, count)
  │
  ▼
sys_write() → ksys_write() → vfs_write()
  │
  ▼
ext4_file_write_iter() → ext4_buffered_write_iter()
  → generic_perform_write()  —— 页缓存层
  │
  ├─ 1. ext4_write_checks() 检查写入范围、追加等条件
  ├─ 2. 按页循环:
  │     ├─ a_ops->write_begin() 准备并锁定页缓存页,必要时读取部分页旧数据
  │     ├─ copy_page_from_iter_atomic() 把用户数据复制到页
  │     ├─ a_ops->write_end() 完成文件系统记账,更新 i_size 并设置页脏状态
  │     └─ balance_dirty_pages_ratelimited() 在脏页过多时限流写进程
  │
  ├─ 3. 更新 ki_pos;若是 O_SYNC/O_DSYNC,再由 generic_write_sync() 等待持久化
  └─ 4. 普通缓冲写通常返回已复制的字节数,不等待数据真正落盘
        │
        ▼ (异步,稍后由 flusher 线程回写)
  writeback_sb_inodes() → writeback_single_inode()
    → do_writepages() → mapping->a_ops->writepages()
      → ext4_writepages()
        → mpage_prepare_extent_to_map() 收集待写区段
        → mpage_map_and_submit_extent() / mpage_map_and_submit_buffers() 映射并提交页面
        → submit_bio() → 块层 → 驱动 → 磁盘
        → 完成后清除页的 Dirty 标志
5.5.3 fsync():强制同步
fsync(fd) 强制将文件的脏页和元数据(inode)同步到磁盘:
调用
filemap_fdatawrite()提交文件所有脏页的写回。等待所有写回完成(
filemap_fdatawait())。调用
file->f_op->fsync()同步 inode 元数据到磁盘。对于支持 journal(日志)的文件系统(ext4/xfs),还需要等待日志提交。
fdatasync() 是 fsync() 的轻量版本,只同步数据和必要的元数据(如文件大小),不同步访问时间等非必要元数据,性能更好。
5.6 块层与 IO 调度
5.6.1 struct bio — 块 IO 请求
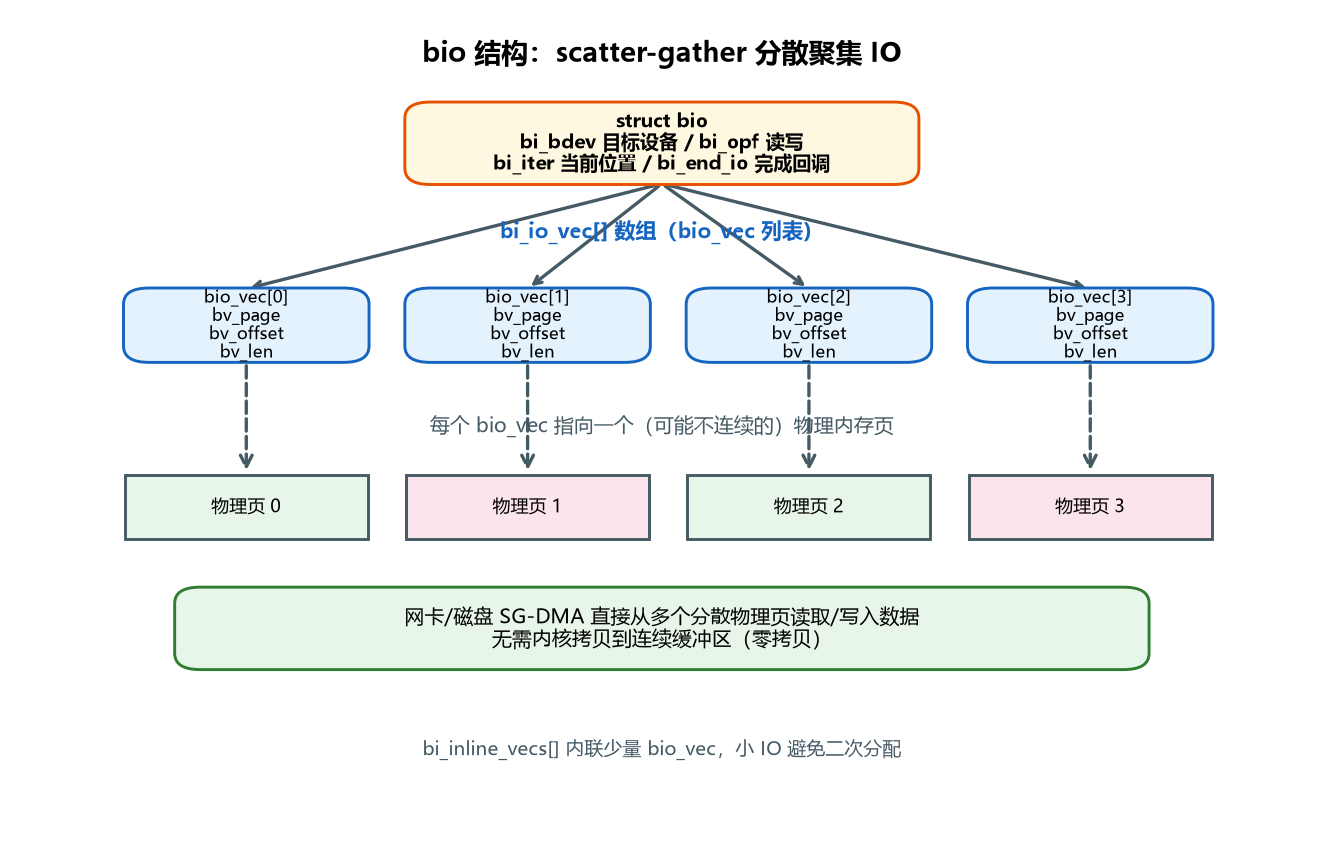
源码位置:include/linux/blk_types.h
bio(block IO)是块层的核心数据结构,描述一次块 IO 请求:
struct bio {
    struct bio *bi_next;            /* 请求队列链表 */
    struct block_device *bi_bdev;   /* 目标块设备 */
    unsigned int bi_opf;            /* 操作类型和标志(REQ_OP_READ/WRITE/DISCARD 等) */
    unsigned short bi_flags;        /* BIO_* 标志 */
    unsigned short bi_ioprio;       /* IO 优先级 */
    blk_status_t bi_status;         /* 完成状态 */
    atomic_t __bi_remaining;        /* 剩余未完成的分段数(bio 被拆分时使用) */

    struct bvec_iter bi_iter;       /* 当前迭代位置(扇区号、段索引、偏移) */

    bio_end_io_t *bi_end_io;        /* IO 完成回调函数 */
    void *bi_private;                /* 回调函数的私有数据 */

    unsigned short bi_vcnt;          /* bio_vec 数量 */
    unsigned short bi_max_vecs;      /* 最大 bio_vec 数 */
    struct bio_vec *bi_io_vec;       /* 散列表(指向内存页的数组) */
    struct bio_vec bi_inline_vecs[]; /* 内联的 bio_vec(小请求避免二次分配) */
};
struct bio_vec — 散列表项:
struct bio_vec {
    struct page *bv_page;    /* 指向内存页 */
    unsigned int bv_len;     /* 数据长度 */
    unsigned int bv_offset;  /* 页内偏移 */
};
关键设计:
bi_io_vec是一个bio_vec数组,每个元素描述一个内存页中的一段数据。这使得 bio 可以描述分散在多个物理页中的数据(scatter-gather DMA),无需数据拷贝。bi_iter记录当前处理到哪个扇区、哪个 bio_vec,支持 bio 被设备驱动分段处理(如设备一次只能处理一定大小的 IO)。bi_end_io是完成回调,IO 完成后由驱动调用,通知上层(如标记页 Uptodate、唤醒等待进程)。bi_inline_vecs是内联的 bio_vec 数组,对于小 IO(少于内联数量)不需要额外分配 bio_vec 数组,减少内存分配开销。
5.6.2 submit_bio() 详解
源码位置:block/blk-core.c
blk_qc_t submit_bio(struct bio *bio)
{
    /* cgroup IO 节流:如果 bio 属于被限流的 cgroup,延迟提交 */
    if (blkcg_punt_bio_submit(bio))
        return BLK_QC_T_NONE;

    /* IO 统计 */
    if (bio_has_data(bio)) {
        unsigned int count;
        if (op_is_write(bio_op(bio)))
            count_vm_events(PGPGOUT, count);  /* 写扇区数 */
        else {
            task_io_account_read(bio->bi_iter.bi_size);
            count_vm_events(PGPGIN, count);   /* 读扇区数 */
        }
    }

    /* 如果是读操作且属于 workingset(活跃工作集),标记内存压力 */
    if (bio_op(bio) == REQ_OP_READ && bio_flagged(bio, BIO_WORKINGSET)) {
        psi_memstall_enter(&pflags);
        ret = submit_bio_noacct(bio);
        psi_memstall_leave(&pflags);
        return ret;
    }

    return submit_bio_noacct(bio);
}
submit_bio_noacct() → __submit_bio() → blk_mq_submit_bio(),进入多队列块层。
5.6.3 blk-mq 多队列块层
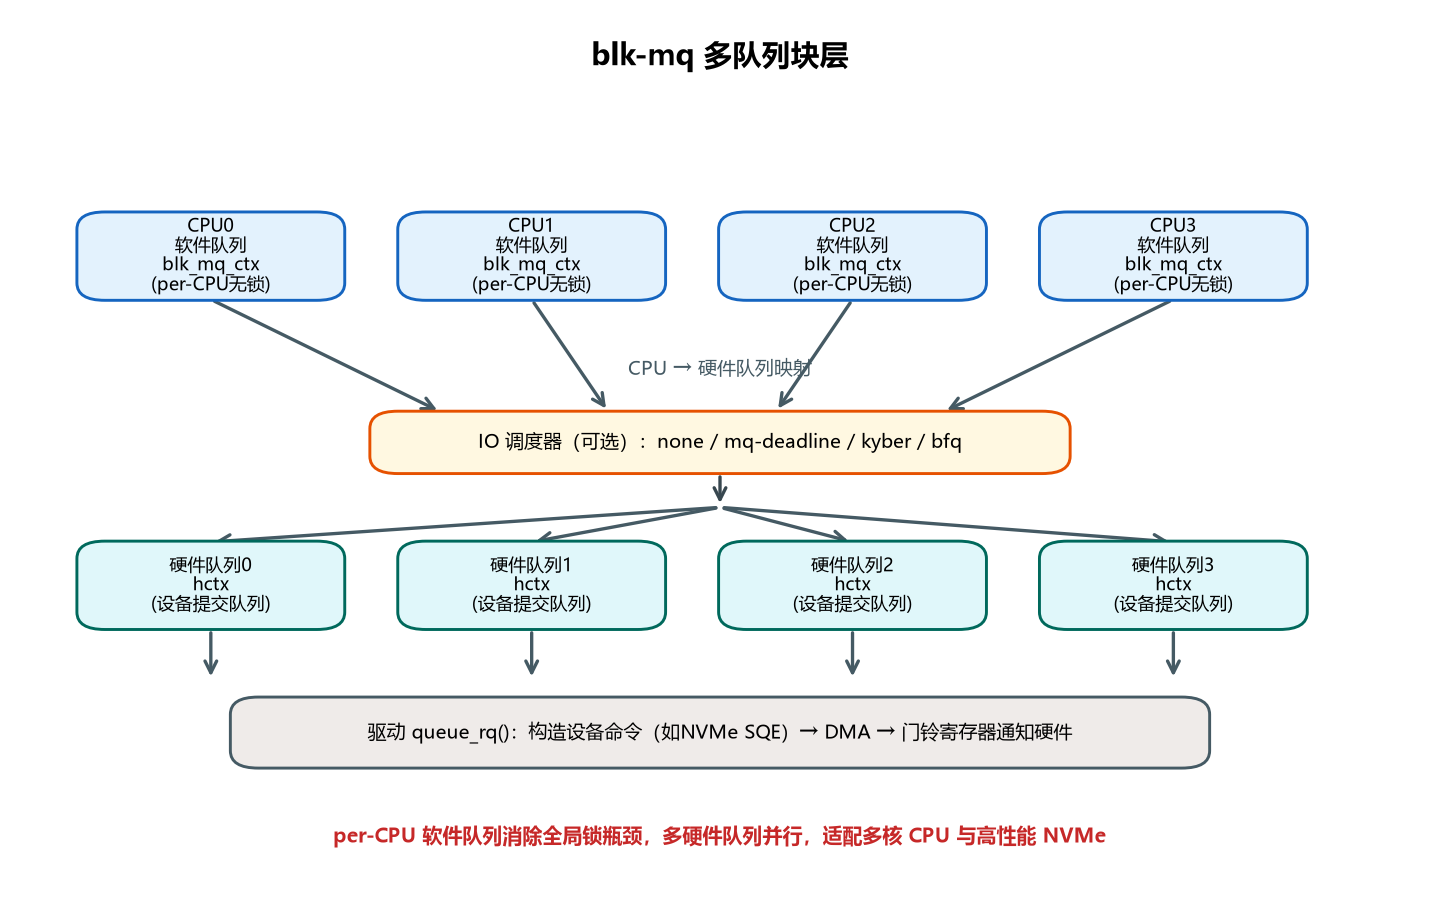
传统的单队列块层(Single Queue)有一个全局请求队列和锁,在多 CPU 高并发下成为瓶颈。blk-mq(Multi-Queue)从 3.13 版本引入,5.15 已成为默认(单队列已移除):
┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐
│  CPU 0   │ │  CPU 1   │ │  CPU 2   │ │  CPU 3   │
│ 提交 bio  │ │ 提交 bio  │ │ 提交 bio  │ │ 提交 bio  │
└────┬─────┘ └────┬─────┘ └────┬─────┘ └────┬─────┘
     │              │              │              │
     ▼              ▼              ▼              ▼
┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐
│ 软件队列0 │ │ 软件队列1 │ │ 软件队列2 │ │ 软件队列3 │  per-CPU,无锁
│(blk_mq_ctx)│ │(blk_mq_ctx)│ │(blk_mq_ctx)│ │(blk_mq_ctx)│
└────┬─────┘ └────┬─────┘ └────┬─────┘ └────┬─────┘
     │              │              │              │
     └──────────────┴──────┬───────┴──────────────┘
                           │ 映射(CPU → 硬件队列)
                           ▼
                    ┌─────────────┐
                    │  硬件队列 0  │  → 驱动 queue_rq() → 设备
                    │  硬件队列 1  │  → 驱动 queue_rq() → 设备
                    │  硬件队列 2  │  → 驱动 queue_rq() → 设备
                    │  硬件队列 3  │  → 驱动 queue_rq() → 设备
                    └─────────────┘
关键设计:
软件队列(Software Queue):每 CPU 一个,提交 bio 时无需加锁(per-CPU 数据)。
硬件队列(Hardware Queue):对应设备的硬件提交队列(如 NVMe 的 Submission Queue),数量由设备决定(NVMe 通常支持 64 个队列)。
映射:软件队列到硬件队列的映射(默认是 CPU 到硬件队列的轮询或亲和映射),减少硬件队列的锁竞争。
IO 调度器:可以在软件队列和硬件队列之间插入 IO 调度器(mq-deadline/kyber/bfq),对请求排序合并。对于 NVMe 等高性能设备,通常使用
none(不调度),直接提交。
5.6.4 IO 调度器
调度器 | 特点 | 适用场景 |
|---|---|---|
| 不调度,按提交顺序直接提交 | NVMe SSD(低延迟、高 IOPS) |
| 按 LBA 排序合并,同时保证每个请求有截止时间(读 500ms/写 5s),避免饥饿 | SSD(默认) |
| 基于设备实际延迟动态调整读写队列深度,目标是控制延迟 | 对延迟敏感的 SSD |
| Budget Fair Queueing,按进程分配 IO 预算(带宽),类似 CFS 的思想,提供更好的交互体验 | 机械硬盘、桌面系统、需要 QoS 的场景 |
IO 调度的核心目标:
排序:按磁盘 LBA(逻辑块地址)排序,减少机械硬盘的寻道时间(对 SSD 意义不大但仍有合并作用)。
合并:将相邻的 IO 请求合并为一个大请求,减少设备交互次数。
公平性:保证每个进程/请求都能获得合理的 IO 带宽,不饿死。
延迟控制:保证请求在可接受的时间内完成。
5.7 文件系统实例:ext4 简介
ext4(Fourth Extended File System)是 Linux 最常用的文件系统,是 ext3 的后继者。关键特性:
Extent(区段)映射:用 extent(起始块号 + 长度)代替间接块映射,大文件更高效。extent 存储在 inode 的
i_block中(内联 4 个 extent),超过则用 extent 树(B+ 树)。日志(Journaling):元数据日志(默认 ordered 模式),崩溃后快速恢复,无需漫长的 fsck。日志可以是文件系统内的 inode,也可以是外部设备。
延迟分配(Delayed Allocation):写文件时不立即分配磁盘块,而是延迟到脏页回写时才分配。这样可以积累更多数据,分配更大的连续块,减少碎片。
多块分配(Multiblock Allocator):一次调用分配多个连续块,而不是逐块分配,提高分配效率和连续性。
大文件支持:最大文件大小 16TB(4KB 块),最大文件系统大小 1EB。
时间戳精度:纳秒级时间戳(ext3 是秒级)。
快速 fsck:未使用的块组跳过检查,fsck 速度大幅提升。
ext4 的磁盘布局:
┌──────────────────────────────────────────────┐
│  Block Group 0        Block Group 1   ...    │
│ ┌──────────────────┐ ┌──────────────────┐     │
│ │ Super Block      │ │ Super Block(备份)│     │
│ │ Group Descriptors│ │ Group Desc(备份) │     │
│ │ Block Bitmap     │ │ Block Bitmap     │     │
│ │ Inode Bitmap     │ │ Inode Bitmap     │     │
│ │ Inode Table      │ │ Inode Table      │     │
│ │ Data Blocks      │ │ Data Blocks      │     │
│ └──────────────────┘ └──────────────────┘     │
└──────────────────────────────────────────────┘
文件系统被划分为多个块组(Block Group),每个块组包含自己的块位图、inode 位图、inode 表和数据块。块组的设计减少了文件数据和元数据之间的寻道距离(同一文件的 inode 和数据块尽量在同一个块组)。
5.8 存储子系统总结
用户态 open/read/write/mmap/fsync
        │
        ▼
VFS(统一接口,超级块/inode/dentry/file,函数表多态)
        │
        ▼
具体文件系统(ext4/xfs/btrfs)
  inode 元数据 + extent/块映射 + 日志
        │
        ▼
Page Cache(address_space + XArray)
  读:命中即返回,未命中读磁盘 + 预读
  写:写缓存标记 Dirty,异步回写(write-back)
        │
        ▼
Block 层(bio 构造 + IO 调度 + blk-mq 多队列)
  bio:scatter-gather 描述分散内存页
  IO 调度:排序/合并/公平性/延迟控制
  blk-mq:per-CPU 软件队列 + 硬件队列,减少锁竞争
        │
        ▼
块设备驱动(NVMe/SATA/SCSI)
  命令构造 + DMA + 中断完成
        │
        ▼
存储硬件(HDD/SSD/NVMe)
本章要点:
分层抽象:VFS → 文件系统 → 页缓存 → 块层 → 驱动,每层解决不同问题,通过函数表多态支持多种实现。
页缓存 + write-back:用内存缓存磁盘数据,写操作只写内存异步回写,将磁盘级延迟(毫秒)降低到内存级(微秒)。
预读与延迟分配:顺序读预取后续页,写延迟分配磁盘块,通过预测和批处理提高效率。
bio scatter-gather:用 bio_vec 数组描述分散内存页,支持 DMA 直接传输,无需数据拷贝。
blk-mq 多队列:per-CPU 软件队列 + 多硬件队列,消除全局锁瓶颈,适配现代多核 CPU 和高性能 NVMe 设备。
日志与一致性:文件系统日志(journal)保证崩溃后元数据一致性,快速恢复。
DISCUSSION
评论